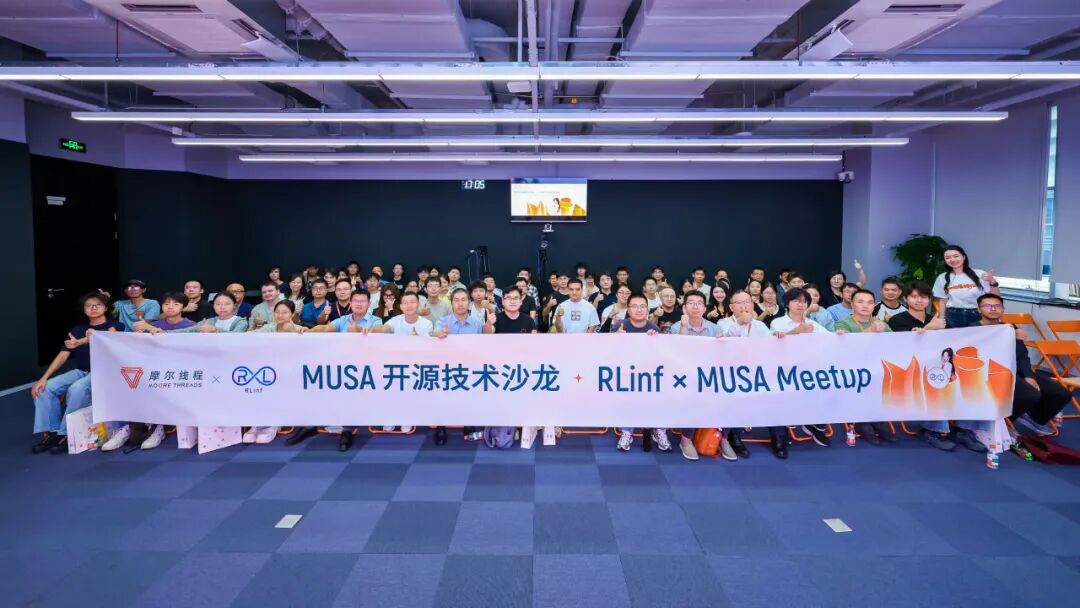
9月19日,由摩尔线程主办的“MUSA开源技术沙龙:RLinf × MUSA Meetup”在北京圆满落下帷幕。本次沙龙从系统框架、集群实测、真实案例到算法演进四个维度,全面复盘了MUSA与RLinf软硬协同攻坚具身“工程战”的实战答卷。
会上,RLinf开源框架负责人、清华大学深圳国际研究生院助理教授于超透露,RLinf官方已正式支持MUSA后端运行,并上线相应部署文档;同时,官方CI自0.3版本起接入摩尔线程MTT S5000,所有代码commit在合入主分支前均须基于国产算力完成自动化验证。与此同时,双方正联合打造基于国产GPU的端云协同具身智能框架,云端采用MTT S5000、端侧采用MTT E300,覆盖训练、推理、仿真与渲染全场景。
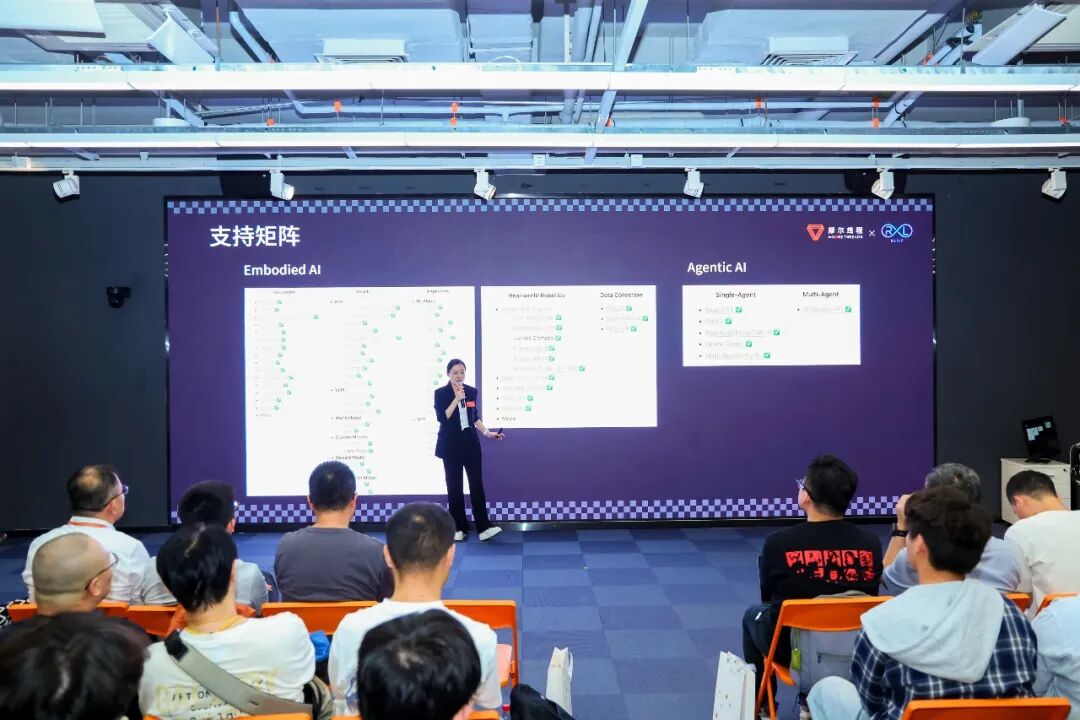
RLinf是首个面向具身智能的“仿训推一体化”大规模强化学习框架,由清华大学、无问芯穹联合发布,已于2025年9月开源,目标是打通渲染、训练、推理三个环节在系统层面的割裂,让开发者在统一平台上完成从仿真环境交互到策略梯度更新的完整闭环。
围绕这一目标,RLinf持续快速迭代,多项成果被NeurIPS、OSDI等顶级会议收录:M2Flow编程范式大幅降低了大规模RL系统的开发复杂度;Flow-Noise、Flow-SDE系列算法在四个主流测试集上带来30%~50%的性能提升;USER系统让开发者可以“像使用GPU一样使用机器人”;RL-Co实现了仿真与真机的联合训练。框架实验显示,RL后训练可使VLA模型的执行泛化能力提升超过30%。
谈及与摩尔线程的深度共建,于超表示, 渲染能力是关键考量:“摩尔线程是国内除国际主流GPU厂商之外,少数能在渲染环节提供成熟支持的算力伙伴。”此次官方CI的接入意味着国产算力与国产具身强化学习框架,已从单向“适配”进入双向“共建”阶段。
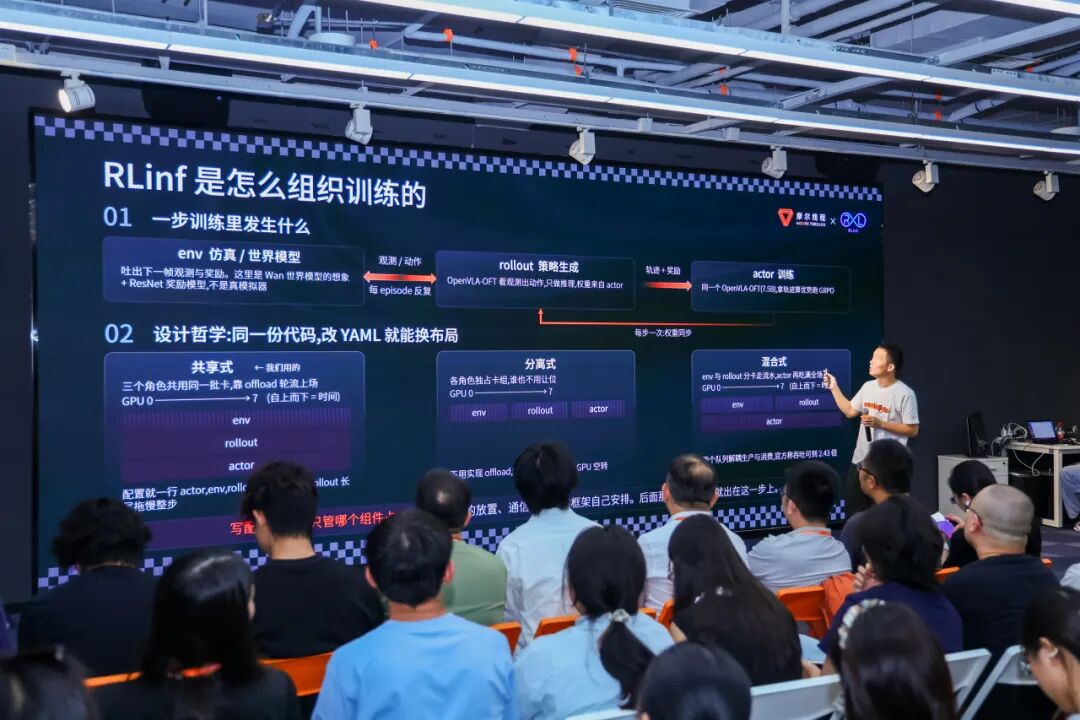
摩尔线程在会上公布了MTT S5000承载前沿具身RL负载的实测结果。团队在RLinf框架上对WoVR负载完成全量适配与复现,采用GRPO算法rollout action,并使用WAN世界模型根据action想象执行结果,最后使用ResNet评估执行结果的对错并给出奖励用于GRPO训练,全程无需真实机器人参与即可完成RL后训练,跑通LIBERO的Spatial与Goal两个任务套件。据团队介绍,在248个并行环境、相同配方与随机种子的控制变量条件下,S5000与国际主流GPU的训练曲线高度吻合,在191步共同窗口内逐步相关系数r=0.976;真机LIBERO-Spatial评估中,两套硬件训练出的策略成功率对齐。
工程优化方面,摩尔线程团队对单步耗时逐相拆解后实施三项改造:图像处理从主机端迁移至GPU端;去噪循环的数值检查由每步5次合并为整轮一次;热路径上的Python标量替换为0维设备张量。改造后,整步耗时从2549秒降至1888秒(下降26%),env交互耗时降低14%,rollout出动作耗时降低20%,GPU空转率由18.5%压缩至3.1%;算子级基准测试显示,S5000的GEMM与注意力性能达到国际主流GPU的1.6-2倍。
团队同时披露了面向具身操作的4DGS高保真场景重建方案,可从操作台的多目视频端到端重建3D动态场景,为RL后训练与Sim2Real提供数据与评估支撑。
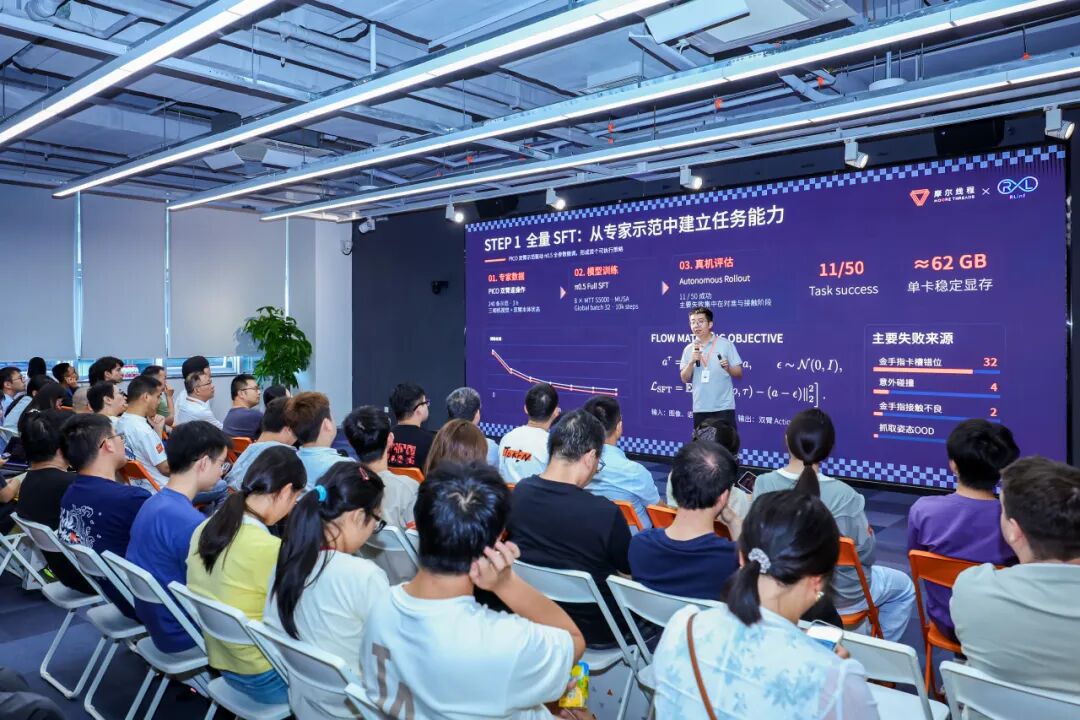
在具身任务上,摩尔线程展示了双臂机器人装配GPU的高难度实战。针对毫米级卡槽对准与复杂物理接触难题,团队基于π0.5跑通了一套“策略自进化数据飞轮”:从最初仅靠240条PICO双臂遥操作数据做全参数微调(SFT),真机成功率只有两成左右;随后三轮DAgger迅速补齐了OOD状态,并配合RECAP针对“斜靠卡槽”“对准偏差”等常见失误做定向纠偏,再到插入阶段引入RL Token,最终真机成功率稳定至92%,精细操作耗时缩短39.5%。
这套飞轮的底层依托是算力与框架的高效协同:MUSA把π0.5全量训练直接落到了单台8卡S5000上,四个阶段共用一套技术栈,无需切换运行环境;RLinf则把原本割裂的四段后训练收敛为一条原生工程闭环,以LeRobot数据契约为桥,加速自定义脚本向RLinf原生编排层平移。
模型落地后,真正的硬仗在真机控制端。面对云端时延,系统通过动作分块让419ms的云端指令赶在530ms执行周期结束前送达,再叠加RTC补偿、时序融合与Ruckig规划,把18.5°的机械臂动作跳变平滑压制到0.23°。后续团队将按“可运行、可加速、可闭环、可验收”四步向端侧SoC芯片迁移,真正实现“云端训练和发布,端侧承担推理、RTC与轨迹执行”的协同闭环。
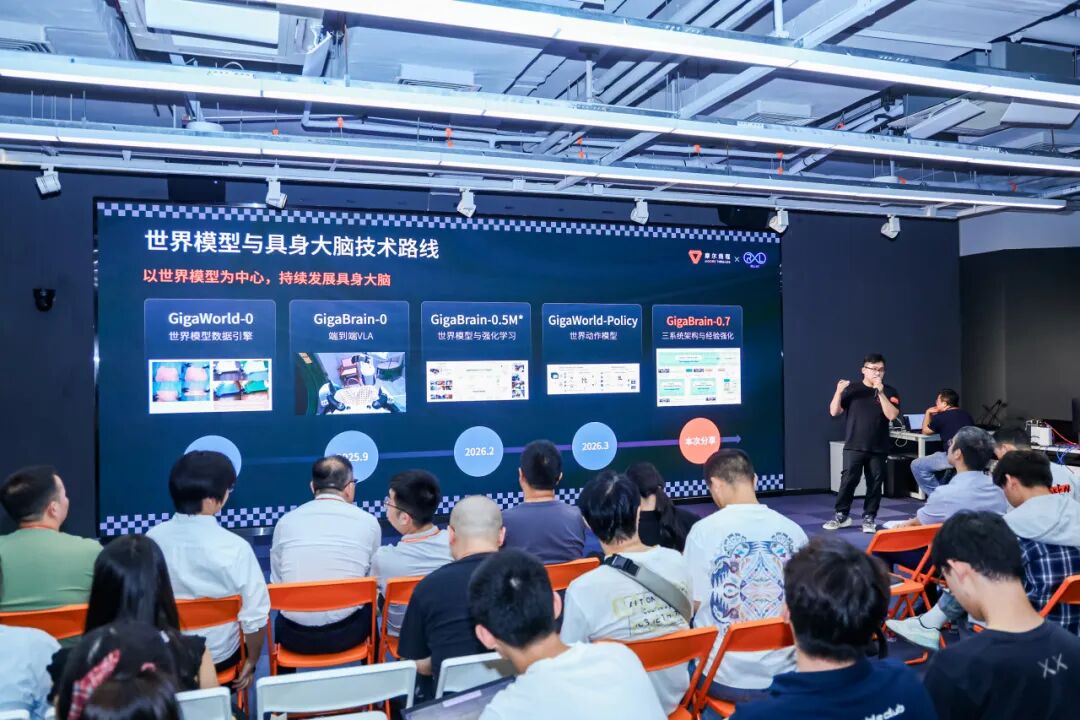
生态合作方面,极佳视界(GigaAI)已基于MTT S5000与夸娥集群,与摩尔线程联合完成驾驶世界模型、具身世界模型、世界行动模型等系列世界模型的训练适配与验证。据极佳视界介绍,其最新开源的GigaBrain-0.7采用System-3架构,将世界模型同时用作数据引擎、训练场与任务评估器;在四项精细操作任务的评测中,平均成功率由SFT基线的30%经离线RL提升至57.5%,在线RL后进一步提升至100%。面向GigaBrain-3等后续版本,双方将继续以软硬协同推进模型能力迭代。
作为国内稀缺的打通“大模型训练-仿真模拟-端侧部署”全链路的GPU企业,摩尔线程以“算、渲、仿”一体的全功能GPU为底座,提出打造面向物理实体的“智能体工厂”。围绕这一体系,摩尔线程向上依托夸娥智算集群与整合物理、渲染、AI三大引擎的MT Lambda仿真平台,向下协同端侧SoC芯片与开发者套件,形成云边端全栈布局,跑通从合成数据、训练到真机部署的工业闭环,并在四足机器狗与双足人形机器人上完成Sim2Real实测验证。目前,MUSA已适配Newton、MuJoCo等主流物理仿真引擎,并接入RoboTwin等仿真环境。
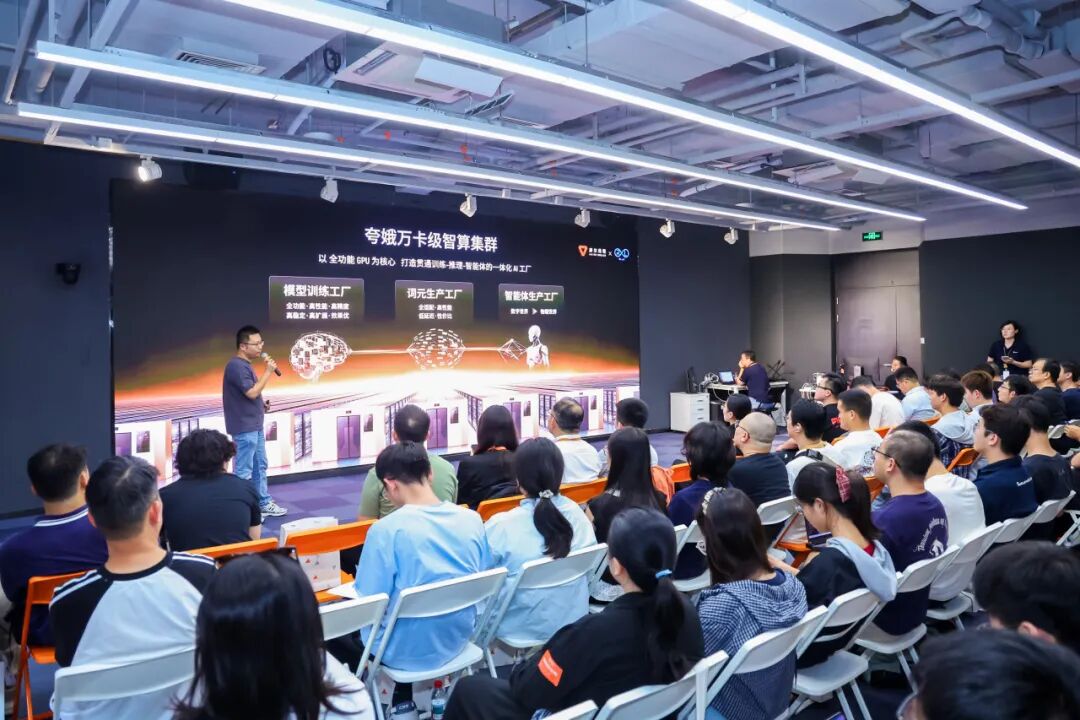
摩尔线程高级副总裁杨上山表示,具身智能对算力的需求是复合的——既需要训练“大脑”的AI算力,也离不开构建虚拟世界的渲染与仿真算力。具身智能管线计算种类多、精度多、框架设备多,恰好契合全功能GPU同时覆盖渲染、物理仿真与AI训练推理的能力,这也是MUSA与RLinf软硬协同的出发点。未来,摩尔线程将持续携手RLinf框架与产业生态伙伴,以软硬协同推动国产算力与具身智能的深度融合,与开发者一起,把这条路走通、走宽、走实。