导语:全球首个“可Scaling”的实时世界模型正式亮相
2026年9月23日,AI视频大模型公司爱诗科技(AIsphere)正式发布通用实时世界模型PixVerse R2,并向用户开放游戏、互动影视及数字人等多个场景体验间。官方将其定位为全球首个具备Scaling(规模化扩展)能力的通用实时世界模型,基于自研的Omni Causal AR(全模态因果自回归)与Real-Time Acceleration(实时加速)两层架构构建。发布后,PixVerse R2迅速登上X平台美区热搜。
爱诗科技创始人兼CEO王长虎表示,随着持续Scaling,PixVerse R2将从当前的创作工具,逐步发展为可随时进入、随时互动的生成式环境,最终成为下一代生成式世界模型的基础设施。
从时间线看,R系列迭代正在提速。今年1月,爱诗科技发布业内首个实时视频世界模型PixVerse R1,将视频生成“从一次性输出的固定片段推进为能够持续运行、实时响应的动态世界”;8月25日,R系列迭代至R2并披露研发进展;9月23日,R2正式发布并向用户开放。此前,爱诗旗下V系列(通用视频大模型)已于今年3月更新至第六代V6,支持画面与声音同步生成,可生成最长15秒的1080P视频。
一、破解“实时”与“通用”的两难:Scaling在五个维度展开
ChatGPT用Scaling Laws(规模定律)证明“模型越大、能力越强”之后,这条定律是否适用于视频,一直是行业悬而未决的问题。过去普遍认为,只有语言这类“离散符号”才适合规模定律,而视频作为“连续高维信号”天生难以扩展。实时世界模型领域还叠加了一对矛盾:要实时,模型必须足够小、足够快,才能在单张显卡上跑出流畅帧率;要通用,模型又必须足够大、见识足够广,才能理解各种复杂场景与物理规律。长期以来,技术路径只能在两者之间取舍,业内几乎没有人真正走通Scaling。
爱诗科技的思路是把“能力”与“速度”解耦:只要架构设计得当,当文本、参考、声音、操作等复杂信号都能被模型统一“理解”,实时世界模型同样可以“越大越强”。在PixVerse R2上,Scaling发生在模型、数据、任务、控制信号、时间尺度五个维度,且五个维度并非各自为战,而是在同一个模型里相互增强,最终转化为三类核心能力的提升:生成质量更高,画面更精细、运动更自然、音视频同步更精准;长程一致性更强,角色不崩、场景不跳、物体不凭空消失,世界状态在长时间运行中保持稳定;多模态控制能力更强,文字、参考图、声音、键盘操作都能被模型稳定地“听懂”并作出反应。
这意味着PixVerse R2不只是一个“更大的模型”,而是一套可以不断扩展的世界模型系统:未来在模型、数据、任务、控制信号、时间尺度任何一个方向持续投入,都有机会转化为更强的世界建模能力。这也是它与传统“为了实时而压缩模型”思路最本质的区别。
二、“言出法随”:可进入、可互动、有记忆的实时世界
在用户体验层面,PixVerse R2带来的最重要变化是“言出法随”:虚拟世界不仅“有记忆地活着”,还能“听懂各种语言”,并对用户的每一个动作作出符合因果关系的反应。
在世界探索场景中,一个可进入、可探索的世界可以通过文字和图像生成。用户可以用WASD键控制角色移动、跳跃、四处探索并随时切换视角,也可以直接输入Prompt下达指令——换角色、加东西、改环境,想到即可实现。过程中,角色、物体和环境之间会持续产生符合空间关系和物理逻辑的互动,如自然的遮挡、接触和碰撞。在官方演示视频25秒处,用户对角色下达「Grow Wings and Fly」指令后,角色随即生出翅膀悬浮飞行;继续下达「Burst into Flames」指令后,角色周身冒起火光并快速降落,落地时火光照亮并引燃周边草地,整个过程自然流畅,没有明显拼接感或跳变。
在剧情互动与实时数字人场景中,世界里的角色可以实时理解并回应用户。在互动影游《畸变回声》中,超级创作者JadeWu利用PixVerse R2搭建了实时数字人推动剧情:玩家与关键角色Eve实时交流即可获取线索、推进剧情并解开谜团。PixVerse R2将实时角色表演、语音、人设、记忆与关系状态统一结合,Eve在多轮交流中始终保持身份一致,其回复、表情和动作与当前上下文对应,并随玩家关系的变化动态调整——用户面对的不再是只会念台词的NPC,而是真正“记得你、认识你”的剧情角色。
三、技术拆解:从“五层接力”到“两个核心引擎”
过去,实时世界模型的通用做法是“为了实时,不得不降低质量”。训练流程需要经过“五层接力”,每接力一次,画质、动作表现和指令理解能力都会折损;模型、数据、任务的规模越往上堆,这套流程越容易散架,训练成本也水涨船高。业内此前的典型链路是把双向模型改成自回归模型,再为各子任务单独训练教师模型,然后做少步蒸馏,最后用模型自己生成的历史回头修正偏差,一套流程走下来有五六道手续。
PixVerse R2反其道而行,把整条流水线收敛成两个核心引擎。其一是Omni Causal AR(全模态因果自回归),定位“能力引擎”:如同大脑,负责持续吸收更多数据、更多任务、更长的时间跨度,把世界模型的理解力和表现力训练到最强,将生成质量、长程一致性、多模态控制放进同一个模型里共同成长。其二是Real-Time Acceleration(实时加速),定位“加速引擎”:从已经跑稳的大模型直接蒸馏出实时模型,把能力尽可能无损地压缩进严格的实时延迟约束。
支撑这条流水线的是两个关键设计。第一是“分层解耦”:把“能力”和“效率”变成两个各自独立、可以分别持续优化的阶段,先穷尽能力边界,再攻克效率边界;基础模型每一次变强,都能顺着同一条流水线稳定传递到实时产品上,而不必推倒重来。第二是“因果内化”:不让模型盲目地“逐帧硬猜下一帧”,而是先理解一整段时空的完整结构,再把这种理解沿时间方向一步一步单向展开,让生成结果更加确定可控,不必依赖“数据堆得够多、模型自己开窍”式的统计涌现。
围绕两个引擎,R2在工程层面还有一系列针对性设计。能力引擎一侧:Dynamic Chunk(动态分块)按控制信号的语义边界自适应切分,让文字、图像、语音、操作这些节奏不同的信号可以被统一处理;多时间尺度记忆让模型同时记得“世界长什么样”和“刚刚发生了什么”;Error Bank(误差库)专门收集模型自己跑偏的状态并反复训练纠错能力,实测让长期画面漂移下降约35.8%,大幅改善长序列生成的稳定性。加速引擎一侧:教师与学生模型共用同一套因果基础,把“重新学习”变成“提速”;DDMD结合对抗正则把条件对齐、分布匹配、对抗正则三类信号分开构造,兼顾响应精度与画面真实感;块稀疏注意力将计算集中在关键关联上,稀疏度超过90%仍几乎不损失效果;金字塔式分阶段生成先定结构、再补细节,用更少算力逼近离线顶级模型的效果。技术报告已在PixVerse官方渠道公开。
四、亿级用户与超50亿元融资构筑的底座
PixVerse R2的发布,背后是爱诗科技在用户规模、资本与技术工程能力上的长期积累。爱诗科技于2023年4月在北京成立,由前字节跳动视觉技术负责人王长虎博士创立,联合创始人为光源资本前执行董事谢旭璋。王长虎2017年加入字节跳动,曾任人工智能实验室总监、集团视觉技术负责人,参与过抖音和TikTok的从0到1,其在大规模实时系统建设与运维方面的经验,被迁移到了世界模型的训练与推理架构中。
用户与收入侧,去年3月完成A5轮融资时,爱诗科技披露全球注册用户数4000万、月活1500万;今年7月完成C+轮融资时,全球注册用户数已上涨至1.5亿,月活用户数超1500万。据披露,去年10月爱诗科技ARR(年度经常性收入)超过4000万美元,其中约80%来自C端订阅,API收入约占20%,绝大部分来自海外用户。
【图表:爱诗科技融资关键节点】
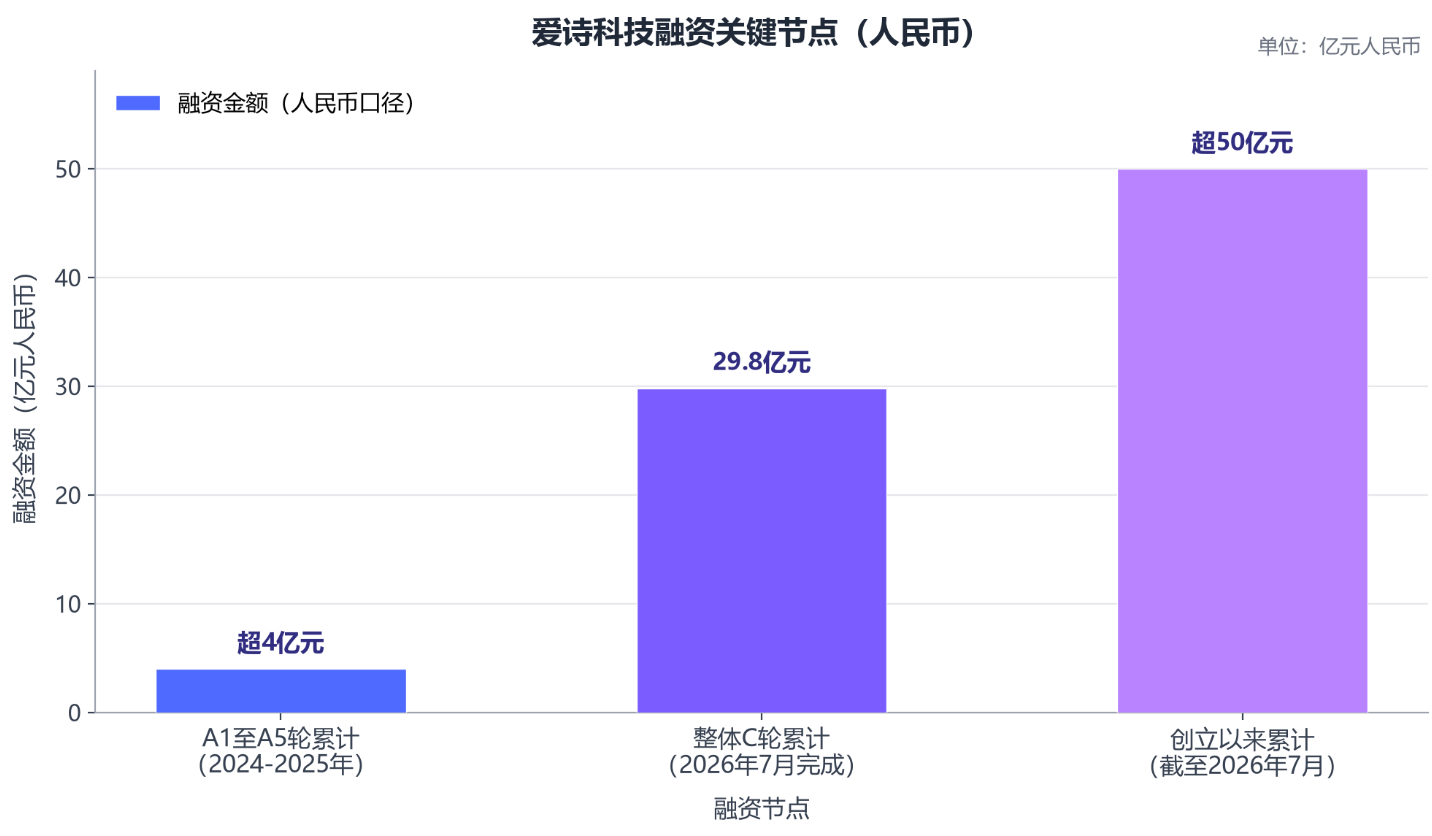
资本侧,自创立以来爱诗科技累计融资超50亿元。2024至2025年间,公司通过A1至A5轮累计完成超4亿元人民币融资;2025年9月完成阿里巴巴领投的6000万美元B轮;此后完成3亿美元C轮融资,由鼎晖系基金领投,刷新亚洲AI视频生成领域最大单次融资纪录;今年7月,C+轮由阿里巴巴领投,整体C轮累计融资29.8亿元人民币,投资方包括Lollapalooza Capital、常春藤资本、惠远资本、钟鼎资本、韩国未来资产、蓝色光标等十余家机构,C轮后估值超过20亿美元(约合人民币134亿元)。另据第一财经“新皮层”独家报道,爱诗科技已秘密递交招股书,有望成为国内视频生成第一股,并据彭博社今年4月报道,公司正与中金公司、摩根大通合作筹备赴港上市事宜,爱诗科技对此不予置评。
技术实力的第三方背书同样明确:截至2026年2月底,全球权威AI评估机构Artificial Analysis发布的榜单中,爱诗科技PixVerse V5.6模型在图生视频与文生视频两大核心赛道均位列全球第2位,稳居全球视频生成模型第一梯队。
五、行业坐标:世界模型赛道进入“实时交互”竞速
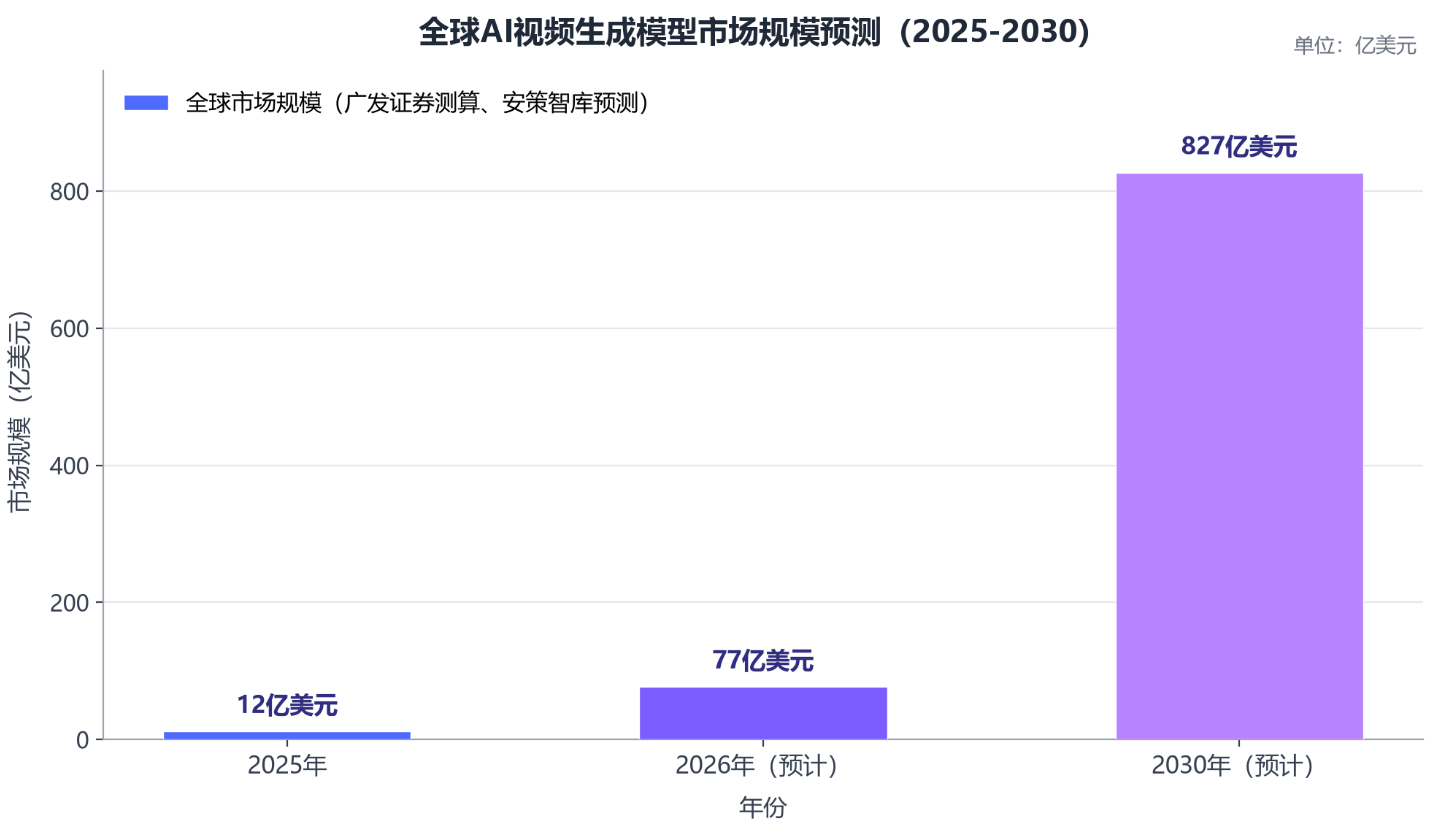
PixVerse R2的发布恰逢AI视频生成市场的高增长窗口。据广发证券测算及安策智库行业报告,2025年全球AI视频生成模型市场收入约12亿美元,中国市场规模约12.15亿元人民币;预计2026年全球行业收入将跃升至77亿美元;到2030年,全球可寻址市场规模有望达到827亿美元,中国市场预计增长至144.39亿元,未来五年全球市场复合增长率约120%。
【图表:2025-2030年全球AI视频生成模型市场规模预测】
竞争格局上,AI视频生成已形成清晰的梯队:国内第一梯队由字节跳动Seedance与快手可灵构成——2026年字节Seedance ARR约20亿美元,快手可灵ARR约5亿美元,可灵以180亿美元估值完成30亿美元Pre-IPO融资;阿里Wan、MiniMax海螺、生数科技Vidu、爱诗PixVerse等厂商同样具备独立模型研发能力。在实时世界模型方向,昆仑万维Matrix-Game 3.5实现了5B参数模型在720p分辨率下单卡20FPS实时生成;谷歌DeepMind Genie 3能以每秒24帧的速度进行实时导航,并在720p分辨率下实现短时交互;阿里巴巴发布了可生成长达三分钟视频的世界模型Happy Oyster;李飞飞创立的World Labs最新融资达10亿美元、估值50亿美元。
与此同时,行业的风向标也在变化。曾被誉为“视频生成之王”的OpenAI Sora已于2026年3月宣布关停相关服务,其日均高达1500万美元的成本消耗为行业敲响警钟;此前OpenAI的C端应用Sora于今年4月关停。李飞飞在最新长文中将世界模型划分为渲染器、模拟器、规划器三个类别,并指出“渲染、模拟、规划三条线正在汇合”。在这一坐标系中,PixVerse R2选择的是“实时交互”这条最接近大众产品化的路线:它既需要生成模型对世界的理解和生成能力,也需要实时系统对延迟、计算和长期运行的控制能力,而其架构创新让“能力”与“速度”成为可以分别持续提升的两个维度。
六、局限与展望:从创作工具到生成式世界模型的底座
客观来看,PixVerse R2仍处于发展初期,存在明确局限:在严格的实时计算和交互延迟约束下,其单次生成质量与前沿离线视频生成模型相比仍有提升空间。但其底层架构与技术路径已经过验证,具备持续迭代和演进的坚实基础。爱诗科技表示,将以PixVerse R2为起点,在模型、数据、任务、控制信号、时间尺度五个维度加大投入,推动R系列模型能力持续增强。
王长虎表示,实时互动视频生成不是世界模型的全部,但它是世界模型最早能被大众感知、最接近产品化、也最容易产生新体验的一条路线。未来,实时世界模型将分阶段演进:从当前的创作工具,逐步发展为可随时进入、随时互动的生成式环境,最终成为下一代生成式世界模型的底座与基础设施。PixVerse R2目前已开放使用,用户可登录https://world.pixverse.video 体验。