比利时布鲁塞尔自由大学人工智能实验室与那慕尔大学计算机学院团队在一项大规模研究中证明:即使没有人类教授语言,也没有预设交流规则,AI智能体仍能通过反复互动,自发形成一套共享的、彼此能够理解的词汇体系。相关成果已发表于计算语言学领域权威期刊,并在37个数据集上完成验证,有望为自动驾驶汽车、机器人与工业传感器等自主系统之间的通信提供新思路。
一、事件快览:语言涌现研究登上《计算语言学学报》
据科技日报报道,比利时布鲁塞尔自由大学(VUB)人工智能实验室与那慕尔大学(UNamur)计算机学院团队于近期完成一项大规模研究,证明自主AI智能体可以在没有人类干预的条件下,自发发展出一套功能性的共享语言。相关成果发表于《计算语言学学报》,其原刊为美国计算语言学学会会刊TACL(Transactions of the Association for Computational Linguistics,MIT Press出版)2026年第14卷。
论文题为「Emergent Communication in Continuous Worlds: Self-Organisation of Conceptually Grounded Vocabularies at Scale」(连续世界中的涌现通信:概念化词汇的大规模自组织),作者为Jérôme Botoko Ekila、Lara Verheyen、Jens Nevens、Katrien Beuls与Paul Van Eecke。两校于2026年10月中旬发布联合通稿,国内科技日报于10月21日刊发报道。
这项研究与以ChatGPT为代表的大语言模型走了不同的技术路线。大型语言模型主要通过训练学习和使用英语等人类语言,而人类语言植根于人的感官体验,未必适合描述机器感知到的所有信息:激光雷达获取距离数据、红外传感器捕捉热辐射、声呐探测周围物体、化学传感器分析物质成分,这些机器感知维度大多没有直接的人类感官对应物。此外,即使两台机器配备相同类型的传感器,实际测量结果也可能存在偏差,进一步增加彼此交流的难度。
研究团队的核心发现是:与其强迫AI系统使用与自身传感器不匹配的人类语言,不如让智能体直接面向其感知数据与任务目标,自组织出「人工自然语言」。论文摘要指出,涌现出的语言约定由符号标签(词形)与子符号概念表示(词义)之间的关联构成,并植根于连续特征空间)。
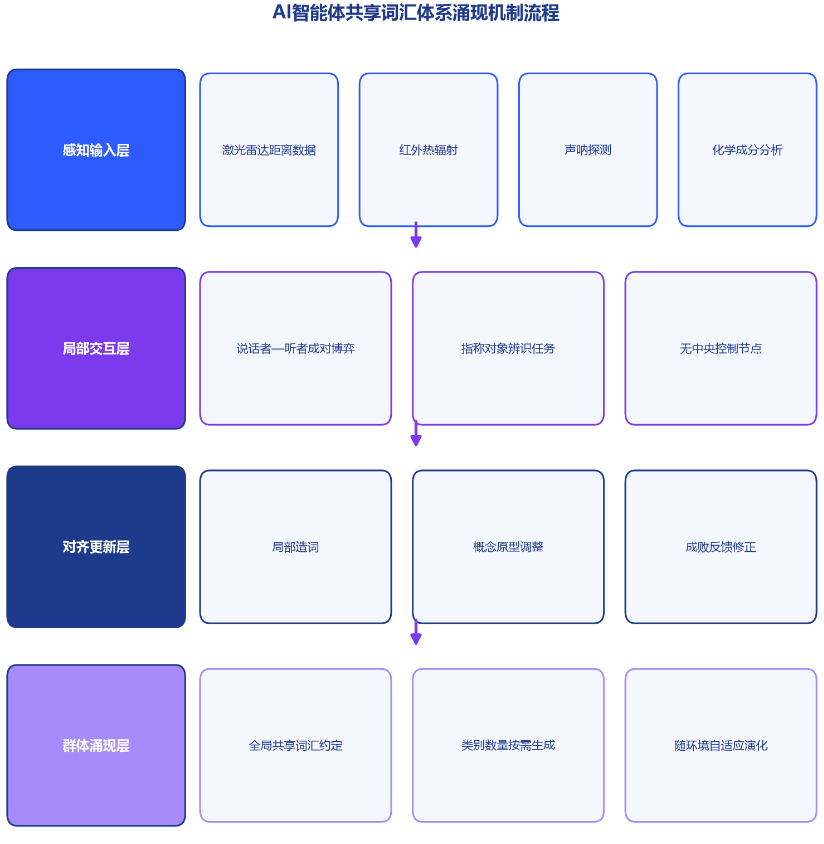
图一 AI智能体共享词汇体系涌现机制流程
二、方法拆解:从局部对话到群体共识的自组织路径
团队没有给AI智能体准备现成的词汇表,也没有设置一套固定的通信编码,而是只提供了人类语言演化背后的基础机制:词语的局部创造、概念原型的调整,以及依据交流成败的反馈更新。据两校联合通稿,那慕尔大学教授Katrien Beuls解释:「最有趣的是,没有任何中央计算机来强加规则。每一次,我们都只让两个智能体在局部层面交流。正是通过这些个体交互与更新,一个全局约定才在整个群体中自发涌现。」
自组织原则使语言能够自动优化:智能体只会创造出高效完成任务所需的类别数量,而不产生多余的细节。这意味着机器语言的词汇规模直接由任务需求决定,形成一种「够用即止」的经济性结构。
布鲁塞尔自由大学人工智能教授Paul Van Eecke则用「红色汽车」作类比说明该方法的产业价值:「在工业或物理应用中,期望不同机器人或车辆上的所有传感器以完全相同的方式校准是不现实的。人类通过语言解决这个问题:当我说我站在『红色汽车』旁边时,即使我们的眼睛捕捉到的颜色值并不完全相同,我们也能相互理解。语言在传感器读数之上提供了一个抽象层,而这正是我们现在让这些AI智能体自主构建的东西。」
值得注意的是,这种机器语言并非人类完全无法理解的「黑话」。由于每个词语对应的概念原型能够与底层传感器数据建立直接联系,研究者可以精确判定某个词的含义,进而分析机器究竟在交流什么。相比之下,许多「黑箱」AI模型的内部决策逻辑难以解释,这构成了两种技术路线在可解释性上的关键差异。
论文实验还显示,这类演化中的语言系统具备较强的鲁棒性:当环境发生变化、传感器数据受到噪声干扰,或个体智能体具有不同的结构配置时,语言会通过持续交互自动适应新的情况。
三、37个数据集实证:从葡萄酒到系外行星的异质性检验
方法的普适性在37个公开数据集上得到验证,数据类型与复杂程度各异:涉及葡萄酒的物理化学性质、美国国家航空航天局(NASA)的系外行星数据、视觉信息,以及鸟类和人脸图像。测试表明,AI智能体在上述各类数据上均成功发展出自己的词汇体系,用于交流多种数据的信息,并将数据有效归组为新的共享概念。
论文原文的量化结果显示:在CLEVR视觉场景实验中,通信成功率在累计约100万次交互后升至99.81%;在面向训练分布之外的泛化测试中,成功率仍分别达到99.75%与99.78%,表明涌现的语言约定在指称前所未见属性组合的实体时不会失效。
针对机器感知异质性这一现实难题,论文设计了异构群体(heteromorphic population)实验:即使各智能体的感知配置互不相同,共享语言依然有效。这一结论直接回应了产业场景中「不同机器传感器无法完全一致校准」的痛点,也是该研究区别于早期智能体通信研究的关键:以往工作多局限于颜色、位置等特征有限的简单环境或预定义类别,而本研究面向反映真实观测数据的高维特征空间。
需要指出的是,上述验证均在计算机仿真环境中完成,所证明的是词汇体系的自发形成,并不意味着AI已经获得人类式的语言能力——智能体并未学习语法、撰写文章或进行开放式对话,而是构建与连续特征空间中的概念相连接的符号标签。
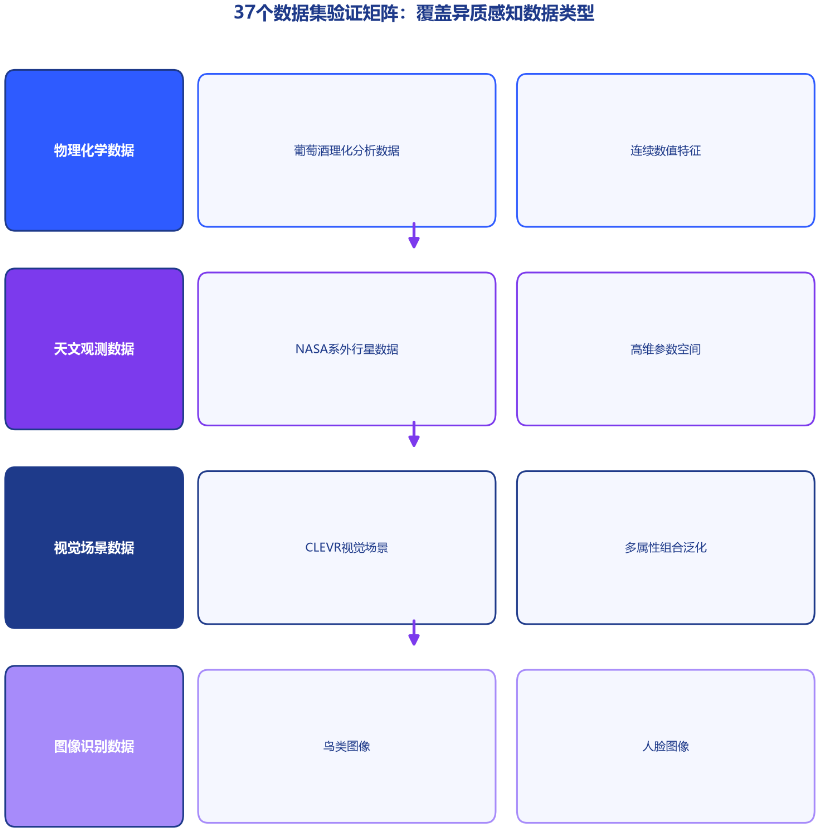
图二 37个数据集验证矩阵:覆盖异质感知数据类型
四、应用图景:自动驾驶、机器人与工业传感器的机器间通信
研究团队认为,这一方法有望为自动驾驶汽车、机器人和工业传感器等自主系统之间的通信提供新思路。其产业逻辑在于:自主系统的通信此前高度依赖预先定义的协议与统一校准的传感器,而自发涌现的词汇体系在传感器读数之上构建抽象层,使不同设备能够在不共享完全相同测量值的前提下实现语义层面的相互理解。
产业侧的数据可以说明这一场景的规模基础。据盖世汽车研究院统计,2025年全年中国激光雷达装机量达338.6万颗,同比增长120.1%,整体渗透率达到11%;另据Yole Group统计,2024年速腾聚创、禾赛科技、华为、图达通四家中国厂商合计占据全球车载激光雷达市场约89%的份额(收入口径)。激光雷达等非人类感官维度传感器的大规模装车,意味着机器间需要交换的感知信息量正快速膨胀,且大量信息本就没有现成的人类语言对应表述。
全球科技产业普遍将人工智能演进划分为生成式人工智能、智能体人工智能与物理人工智能三个阶段;随着实体AI从受控环境走向现实世界,机器人对多样化传感器组合的需求持续提升,自主系统间的通信与协同正成为产业关注点。
从落地节奏看,车路协同、多机器人协作与工业互联网中的状态共享,是该方法最具适配性的三类场景:其一,自动驾驶车辆间需要就路况实体达成一致的指称约定;其二,异构机器人群体需要在不共享硬件规格的条件下协作;其三,工业传感器网络可以在校准基线不一致的设备之间建立语义互通。上述场景的共同特征是「传感器异构、任务明确」,与该方法的能力边界相吻合。
不过,从仿真验证到真实物理系统仍有距离:真实道路与产线环境的噪声水平、算力约束与安全要求均高于实验设置,方法需要在工程层面进一步验证。目前该研究尚处于学术成果阶段,两校通稿将其定位为自主系统通信领域的「重大突破」方向,而非已可商用的技术方案。
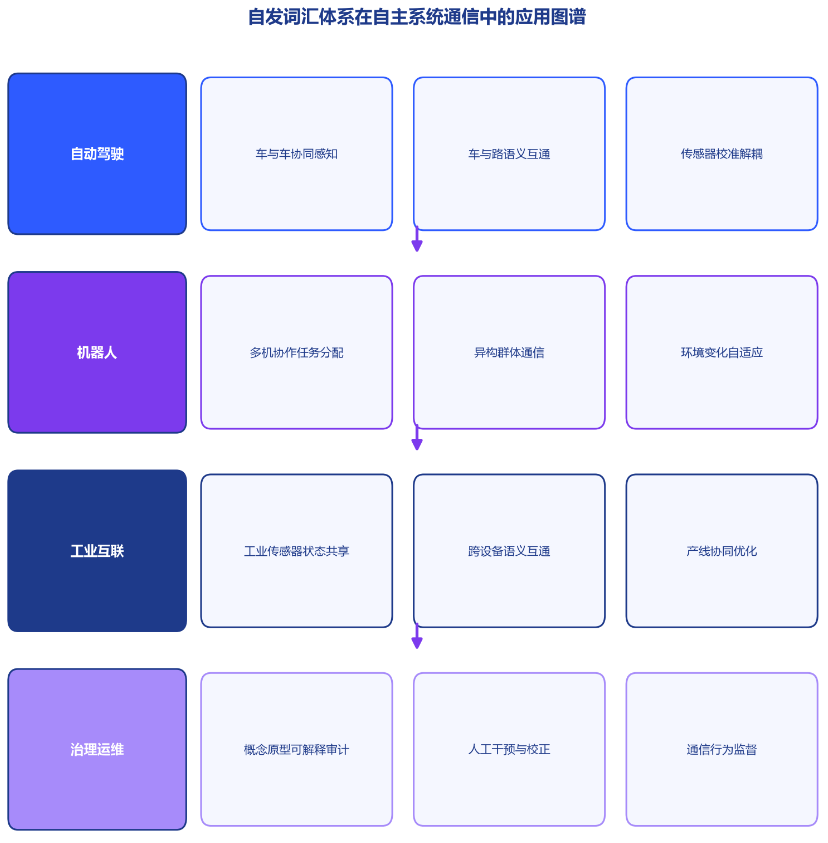
图三 自发词汇体系在自主系统通信中的应用图谱
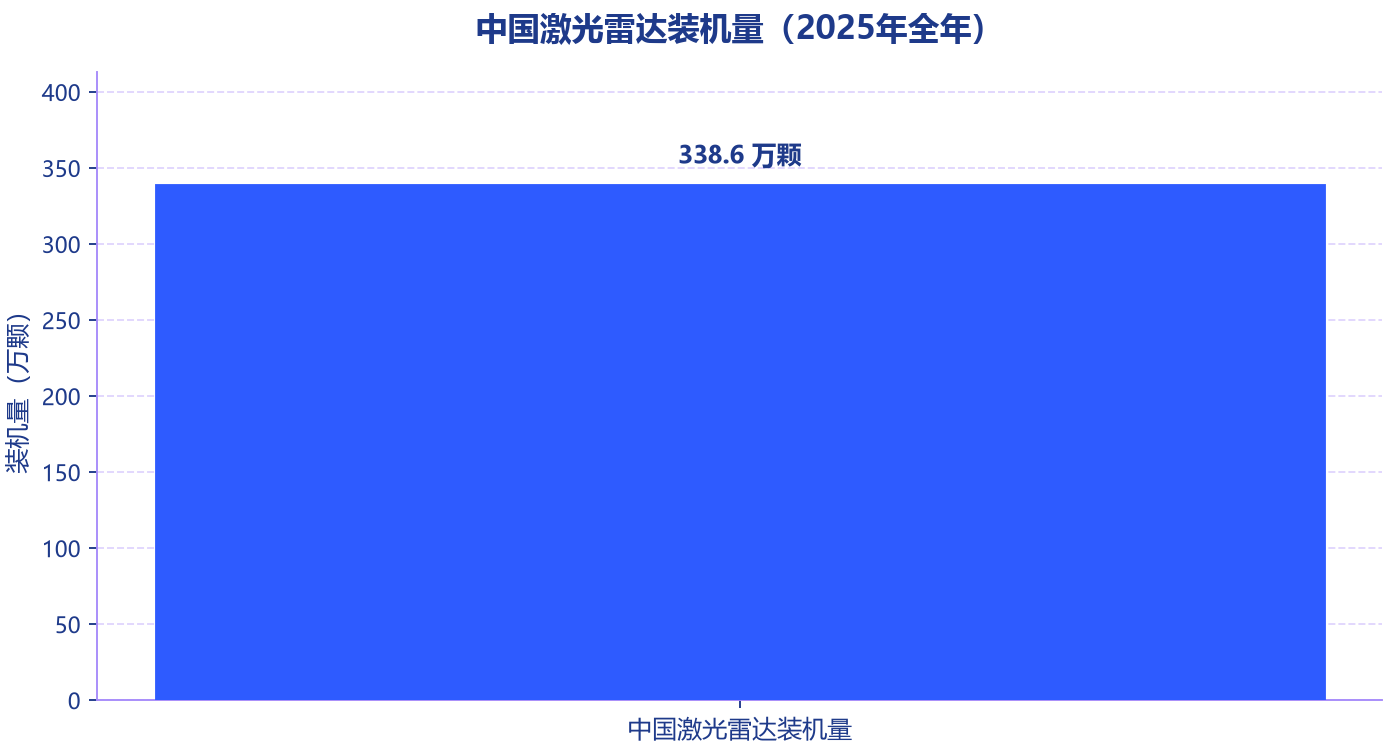
图四 中国激光雷达装机量(2025年全年)
五、风险与治理:可理解性、可干预性与人类监督
机器语言的自发涌现带来了效率想象,也带来了治理命题。科技日报「总编辑圈点」指出:人类要时刻关注机器沟通语言的可理解性,要保证有办法对它们的沟通进行干预和校正。这一提醒指向自主系统通信的两条底线:其一,机器语言必须保持可审计性;其二,人类必须保留对机器通信行为的干预通道。
从技术条件看,该研究提供的方案在可解释性上具备先天优势:由于每个词语的概念原型可以直接关联到底层传感器数值,词义可回溯、可分析,这为通信内容的事后审计提供了抓手。但也应看到,随着交互规模扩大与类别持续演化,词义漂移的监测、异常通信的识别与紧急中止机制,仍需要配套的工程与制度安排。
学界与产业界的共识正在形成:自主系统通信的语义层标准化、安全监管框架与可解释性要求,将与技术本身同步演进。在自动驾驶、机器人与工业互联网等高风险场景中,任何通信机制的部署都应以「人类可理解、可核查、可校正」为前提,这也是该研究从实验室走向产业必须回答的问题。
结论
这项研究以严格的实验证明:语言可以作为一种自组织现象在机器群体中自发形成,而不必依赖人类教学或预设规则。37个数据集上的验证与异构群体下的鲁棒性表现,使该方法具备了面向真实异构感知场景的理论基础。
对产业而言,其价值不在于机器「会说话」,而在于自主系统终于可以在不共享统一校准的前提下实现语义互通,这为自动驾驶、机器人与工业传感器的深度协同提供了新的技术选项。与此同时,可理解性与可干预性必须作为部署前提同步建设——机器语言的涌现越顺利,人类的监督机制就越重要。