你有没有遇到过这些“糟心时刻”:
追剧追到高潮,背景音乐一响,台词全凭猜,遥控器按到手酸;家里吸尘器一开,电视对白立马被“淹没”,只能来回调音量;智能音箱放歌,鼓点软绵绵,换个男声又闷得像隔着被子;对着 AI 玩具喊了三遍,它却只回你一句“我没听清”。
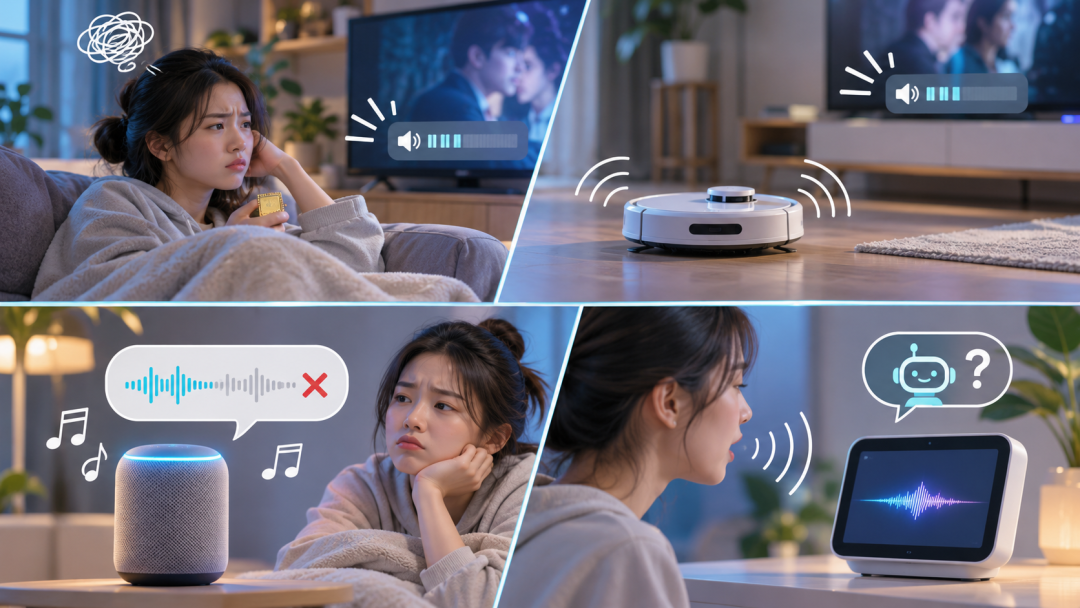
遇到这些情况,我们的第一反应往往是:“喇叭不行”或者“麦克风太差”。但如果你拆开这些设备,会发现硬件其实未必差,真正缺失的,是一个专门负责“调音、降噪、修声”的核心角色。
在电视、智能音箱、会议宝这类产品里,这个统筹声音处理的关键器件,就是 ADSP(音频专用处理器)。
它到底是一颗怎样的芯片?能落地到哪些产品里?又是如何解决上述那些具体的音频痛点的?今天这篇文章,就按“它是什么、芯片里有什么、能用在哪儿、怎么解决具体痛点”的顺序把它说清楚。
一、先搞清楚:ADSP 到底是干什么的
SoC 是“总管”。CPU、GPU、系统、联网、应用全归它管,音频只是它众多任务里的一项。它当然也能做音效,但只能顺手做一层很浅的——做深了就要抢算力,成本也会被拉上去。
DSP 是“数学快手”。单周期乘加(MAC)、地址递增、循环缓冲,这套硬件就是为“逐样本实时算”准备的,神经网络推理它也能跑,但效率天花板在 NPU。而且它只管算:芯片不带模拟前端,麦克风要先进 ADC、声音要过 DAC 和功放。
ADSP 才是“音频专用处理器”。在 DSP 外面,再配上 ADC 与 DAC(把模拟的声音数字化、再把数字信号变回模拟)、麦克风与功放接口、电源管理,并且把音频算法预装好。
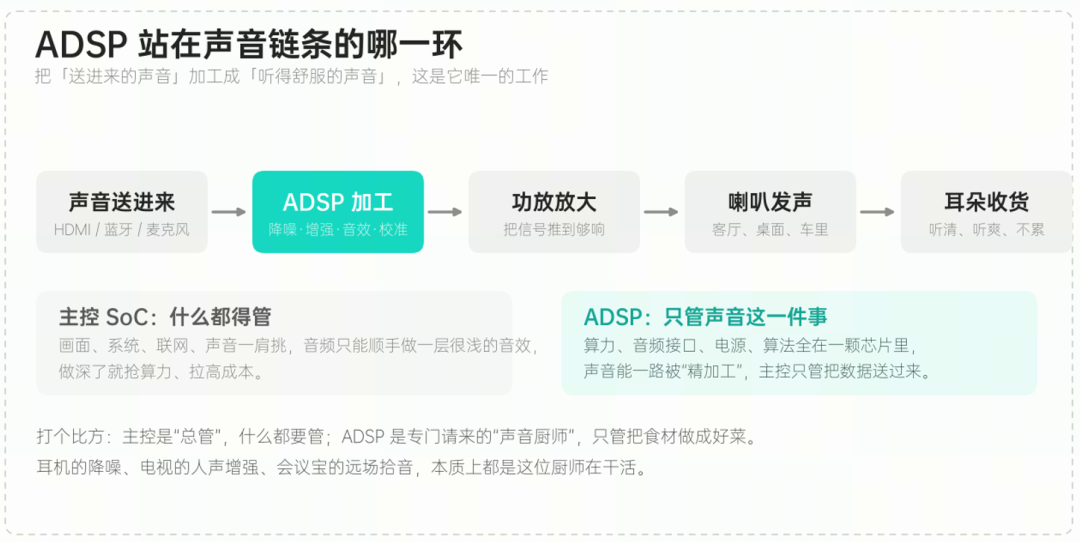
图一 ADSP 站在声音链条的哪一环
为什么不干脆都塞进主控 SoC?三个现实原因——一是算力抢不过主业务,画质、系统、AI 都要吃资源;二是音频接口不一定齐,多路数字麦克风、32 通道 I2S、SPDIF 这些常要额外补芯片;三是音效调优靠长期积累的算法库和调音经验,不是临时写几行代码就能追上的。
所以一颗 ADSP 站在链路里的位置很明确。往下,声音从 HDMI、蓝牙、I2S 进来,先过它——降噪、人声增强、音效、空间校准都在这里完成,再送去功放和喇叭;往上,麦克风收进来的声音也过它——降噪、定向、远场拾音。一上一下,都是绕不开的那一站。
二、硬件规格:AWA89810 拆开看,四套班子
第一套,双核大脑。HiFi4 DSP 最高工作主频 680MHz,带向量浮点单元(VFPU),4 组 32×32 乘加单元加 4 组单精度浮点乘加单元。这不是纸面参数——它决定了 AI 降噪、人声增强这类算法能不能实时跑完。另有一颗 32 位 RISC-V 小核,负责控制、界面、升级这些“杂事”。两个核各干各的,互不打扰。
第二套,大仓库。片上 D-RAM 672KB、I-RAM 256KB,另有 16MB 的 L2 pSRAM;片外可直接挂 16–64Mb 的 NOR Flash,代码能直接从 QSPI NOR Flash 运行,不用先搬到 RAM。
第三套,音频前后门。4 路音频 ADC:24bit、102dB 信噪比、延时小于 4µs,差分输入适配高性能 ECM 麦克风,采样率 8k 到 96k;2 路 DAC:113dB 信噪比、THD 低至 -90dB;4 路音频 PWM:113dB 信噪比,可输出 192k/24bit;8 路 DMIC 数字麦克风输入,正好支撑多麦阵列;SPDIF 收发支持 192k/24bit。
第四套,水电自理。PMU 支持 2.5–5.5V 直接供电,内置 LDO 与 2 路 DCDC,外围器件能省一大把;USB2.0、最多 3 路 UART、2 路 QSPI、SD/MMC、硬件 IR 与 CEC、旋钮编码、JTAG 都在里面。48MHz 晶振,支持 USB 或 OTA 升级。
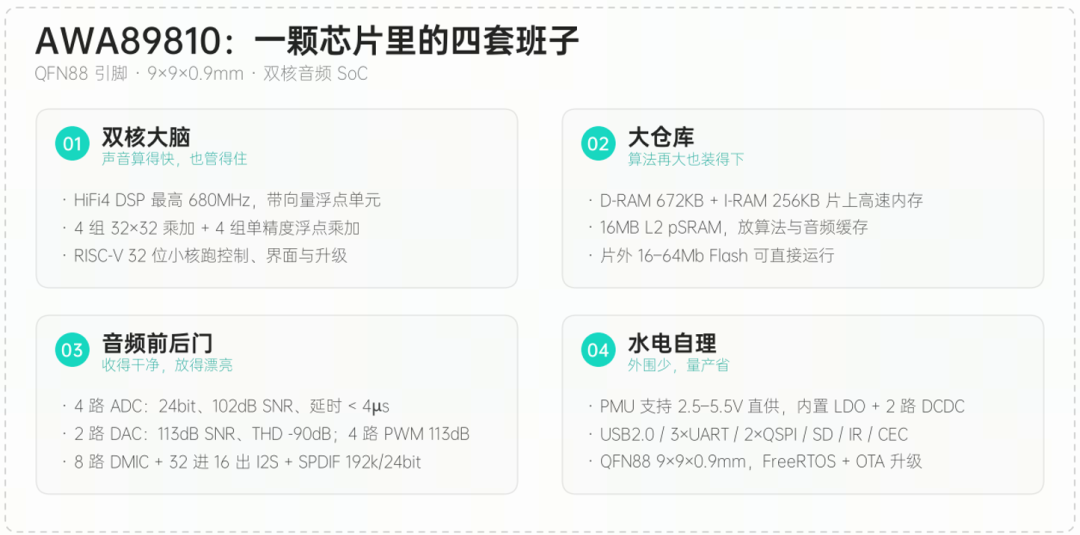
图二 AWA89810:算力、内存、音频接口、电源四件事自己全包
对整机厂来说,这四套班子的意义只有一句:不用再为一颗音频芯片东拼西凑 Codec、外围电源和接口转换——板子更小、BOM 更短、量产更省。
三、能用在哪些地方:四类场景,四类“不舒服”
客厅电视与 Soundbar,是“对白保卫战”。客厅噪声常在 60–75dB:空调、窗外车流、家人说话,再加上沙发吸音、墙面反射,同一台电视在体验店惊艳,搬回家就发闷。用户能做的只有反复按遥控器。
智能音箱,是“小箱体与大低频”的物理矛盾。箱体一小,低频天生气短。靠 EQ 硬拉,音量一大就失真破音;摆位从桌面挪到墙角,音质又换了一副面孔;隔着房间喊它,它还听不见。
会议设备与会议宝,是“多人、多噪、多远”的三重考验。多人同时说话、空调与键盘声不断、人又坐得远——远端听到的往往是一锅粥,而会议场景偏偏最不能含糊。
AI 玩具与机器人,是“孩子说话轻、家里本来就吵”。小声、远距离、旁人插话,三件事叠在一起,设备常常“听错”或“装没听见”,交互体验一下就垮了。
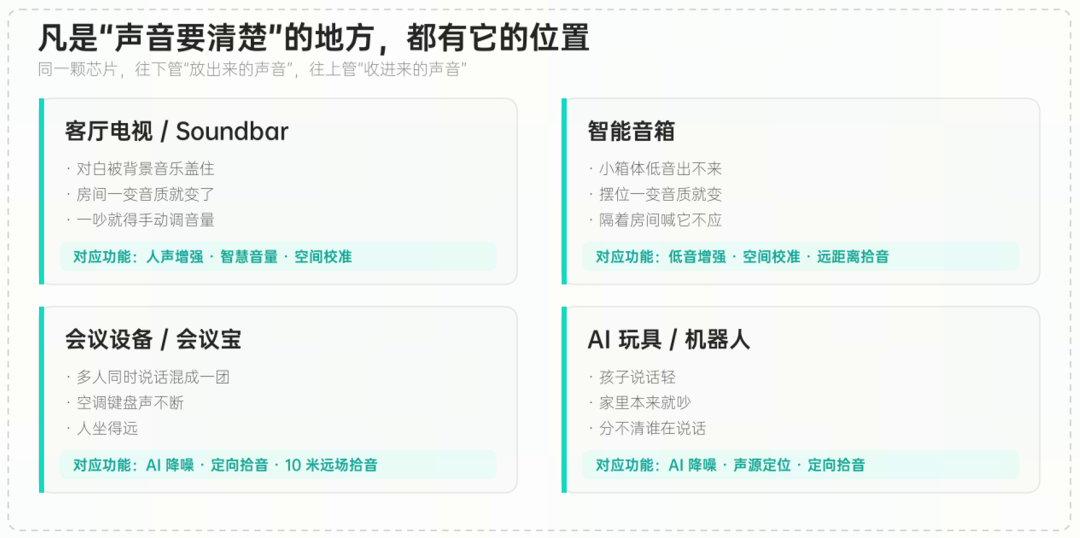
图三 四类场景,四类痛点,对应功能一目了然
这四类场景的共同点:用户买的不是参数,是“别让我再说一遍”。
四、先科普:五个“调音动作”,其实都是常识
EQ,像调音台上的推子。把某一段频段推高或拉低,音色就跟着变亮、变厚。想要人声更透、低频更沉,第一步都是它。
AGC,像自动扶梯。声音小了自动往上抬,一直送到耳朵舒服的高度,所以小音量的片源也能听得清。
MBDRC,像多道水闸。把低、中、高分成几段分别控住,谁冲得太高就压谁。这样音量开大时也不破音、不刺耳。
Dynamic EQ,像随音量自动补妆。音量开大时补一点低频和高频,开小了也不闷——避免“小声听不清、大声听着吵”。
Matrix,像八路分线盒。把声音按声道分给不同的喇叭,各走各的路,是 2.1、5.1 这类多声道系统的骨架,最多可分配 8 个声道。
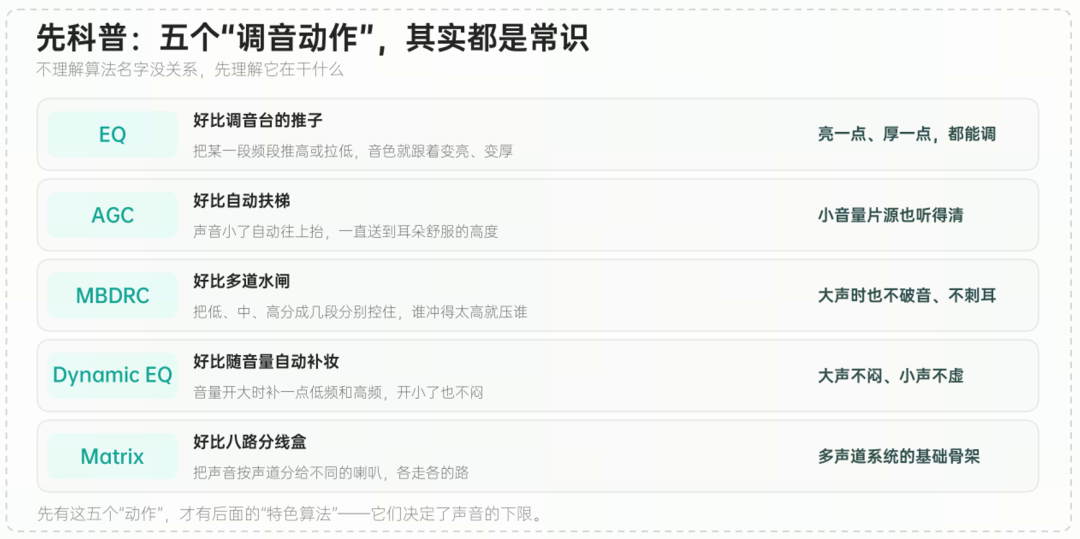
图四 五个基础模块:决定声音的下限
这五个动作决定了声音的下限——不难听、不出错。真正拉开差距的,是下面这几个特色模块。
五、往下走:四个“听得见”的改变
所谓“下行”,就是把声音放出来这一路。四件事,恰好对应四个最日常的抱怨。
1. 人声增强:把“说话的那条线”提出来。追剧时最常遇到的,是爆炸声、配乐、掌声一起响,演员的对白被裹在中间。人声增强的做法不是把整体音量拉高——那只会更吵——而是先“认出”哪一段是人在说话,把这块单独提亮,背景保持原样。原理上,人声在时频图上有稳定的谐波结构,而且时序连贯;音乐和噪声则更杂乱。算法抓住这两个特征,就能把对白与背景分开处理。结果很直观:不用开字幕,也不用反复按遥控器。
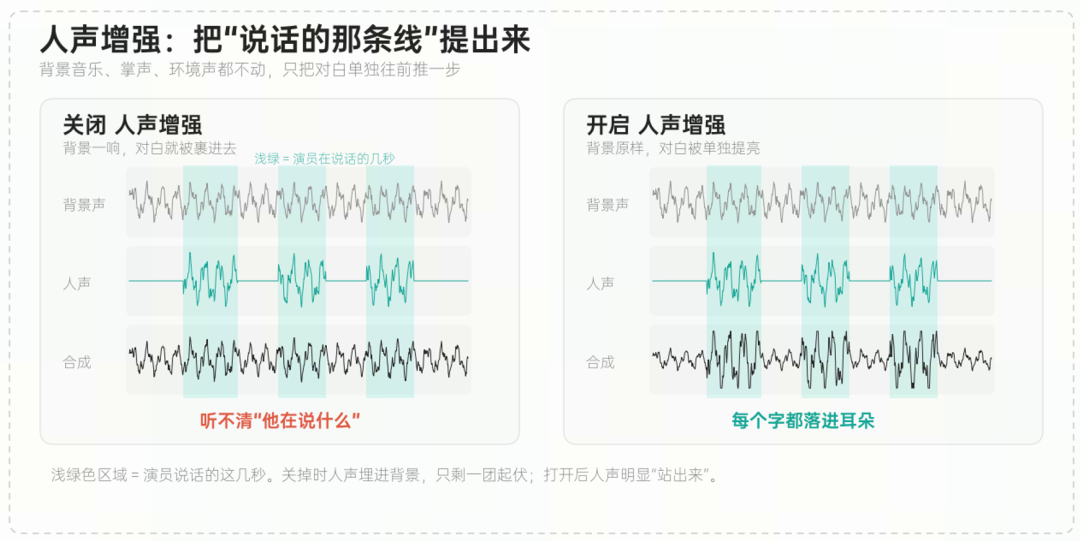
图五 关闭与开启人声增强:背景不动,对白站出来
2. 智慧音量:家里越吵,对白越要“顶上去”。吸尘器一开、孩子一闹,对白瞬间被盖住;一安静下来,声音又大得吓人,以前只能手动调,还总慢半拍。智慧音量用麦克风实时“听”房间有多吵,据此决定该给多大的人声电平:吵就抬,静就收。难点不在会不会调,而在调得够快、够自然——慢了半拍,观众已经错过一句台词;幅度太猛,又会忽大忽小。
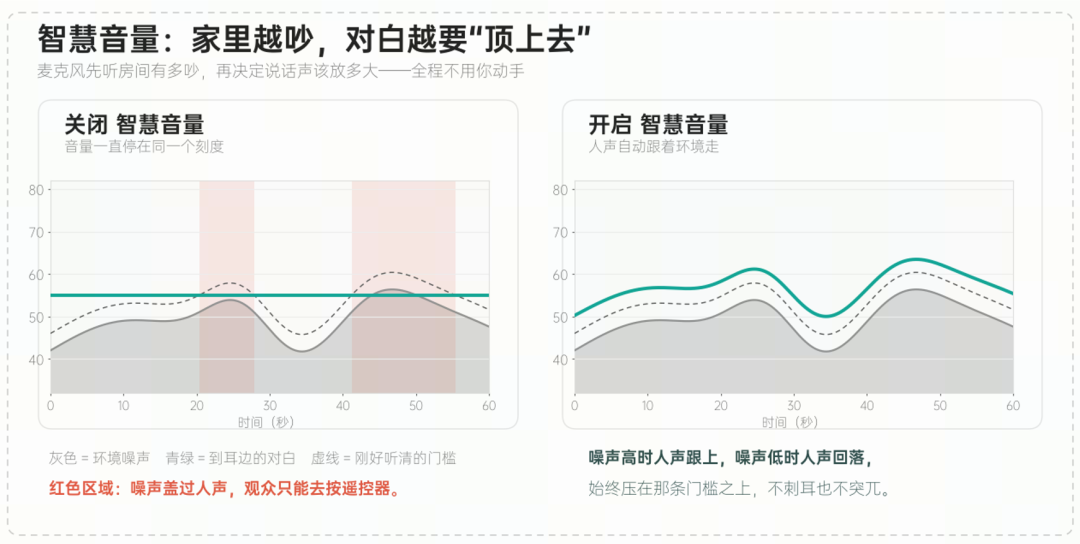
图六 开启智慧音量后,对白始终压在“刚好听清”的门槛之上
3. 低音增强:小箱体也能有弹性,而不是轰头。小音箱、超薄电视,低频在物理上就出不来。传统做法是用 EQ 硬拉,结果低频“虚高”,旁边还鼓出一个峰,音量一大就发糊、破音。低音增强的思路不一样:根据正在放的内容动态补低频,同时补足谐波——人耳本来就会靠谐波“脑补”出缺失的低音,补得对,听着又深又厚,却不轰头。同一首歌里男声要浑厚、女声要甜,算法跟着内容走,才谈得上“弹性”。
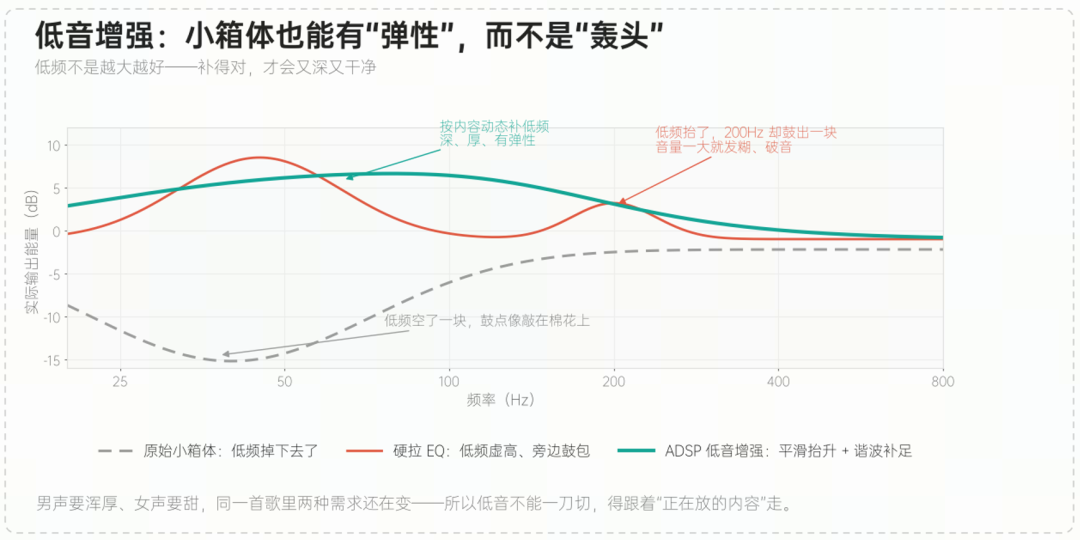
图七 三条曲线:原始小箱体、硬拉 EQ、ADSP 低音增强
4. 空间校准:把“体验店的好声音”搬回家。同一台电视,店里惊艳、家里发闷。问题不在机器,在房间:墙面反射、家具遮挡,会把某些频段顶高、另一些削掉。空间校准先“测”房间——让扬声器发测试信号,用麦克风听回来,算出每个频段的偏差,再反着补回去;同时把反射与混响的影响压下去。它不是把声音变大声,而是把每个频段拉回同一条起跑线。
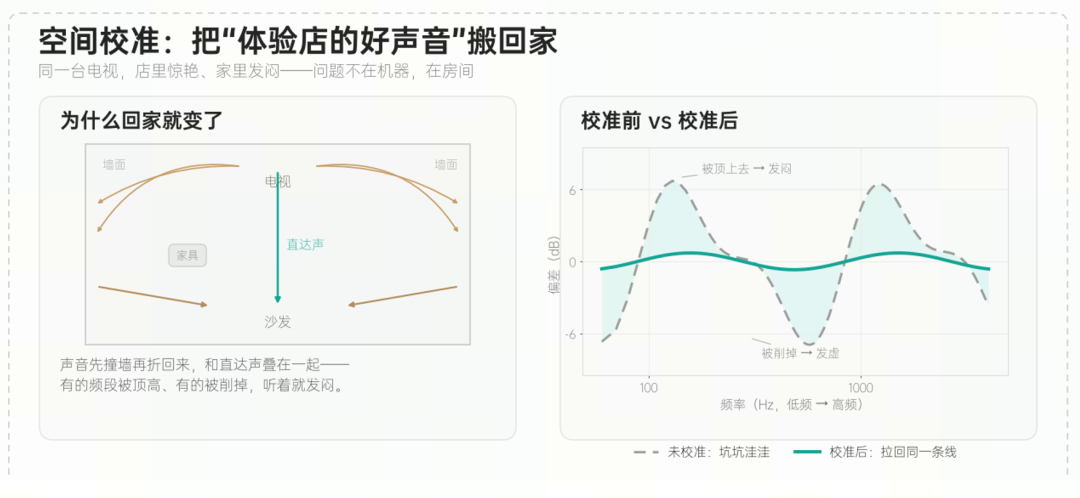
图八 房间会改变声音的平衡,校准把它拉回来
六、往上走:四个“听得清”的动作
“上行”是把声音收进来这一路:麦克风阵列、降噪、定位、远场。这一组能力会在 2026 年底随产品陆续落地。
AI 降噪,先分噪声,再谈压制。空调、风扇是稳态噪声,键盘、餐具、敲门是非稳态噪声,两者在时频域上都和语音高度重叠。工程上常用“传统 + AI”混合:传统算法快速收敛处理稳态,AI 模型补非稳态和瞬态的细节,在有限算力下兼顾效果与延迟。
定向拾音,只听说话人那个方向。8 路 DMIC 组成阵列,把拾音波束指向目标说话人,波束之外的声音被压下去约 6–12dB。会议室里旁边有人接电话、空调在吹,都不再是干扰项。
声源定位,听出声音从哪来。定位之后,设备才能“转向”:摄像头转过去、屏幕亮起来、音箱对着人说。这一步是从“能听见”跨到“会回应”的关键。
远距离拾音,10 米也能听清。远场不是简单把增益拉高——那会把噪声一起拉起来。它靠的是阵列、波束、降噪与回声消除的组合拳,让 10 米内正常音量说话也能被稳定拾取,同时全双工通话不啸叫。
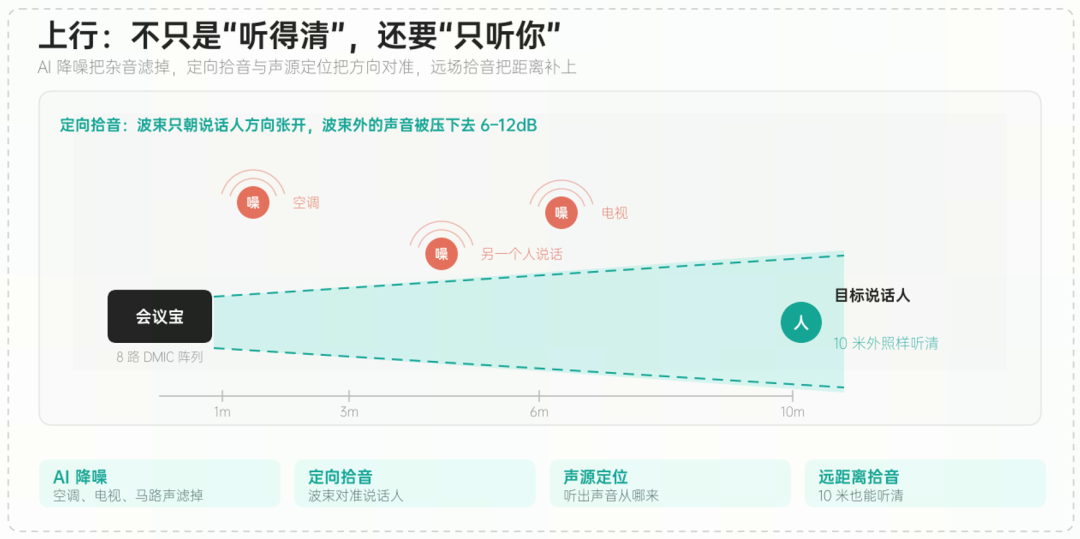
图九 会议场景:波束对准说话人,侧向噪声被压制
说句实话:这些指标都有前提。10 米远场是在安静到中等噪声的室内、正常说话音量下达成的;强混响、多人同时说话,仍需要产品定义上配合阵列布局与安装位置。
七、为什么客户要的是一颗芯片,而不是一堆算法
站在整机厂的角度,真正的痛不是“没有算法”,而是这三条:主控 SoC 自带音效只能做基础,产品讲不出差异,最后只能拼价格;通用 DSP 移植周期长,算法适配、调参、验证全得自己来,一个项目能拖几个月;算法公司交付的是“代码”,不是能过认证的整机方案,接口、电源、驱动还要另补。
ADSP 的答案是把这些一次性包掉:算法预装在芯片里,导入参数就能出声;音频接口与电源都在片内,不用再配 Codec 和外围;背后还有艾为多年的算法积累——9 年以上自研、20 亿台装机验证——做兜底。
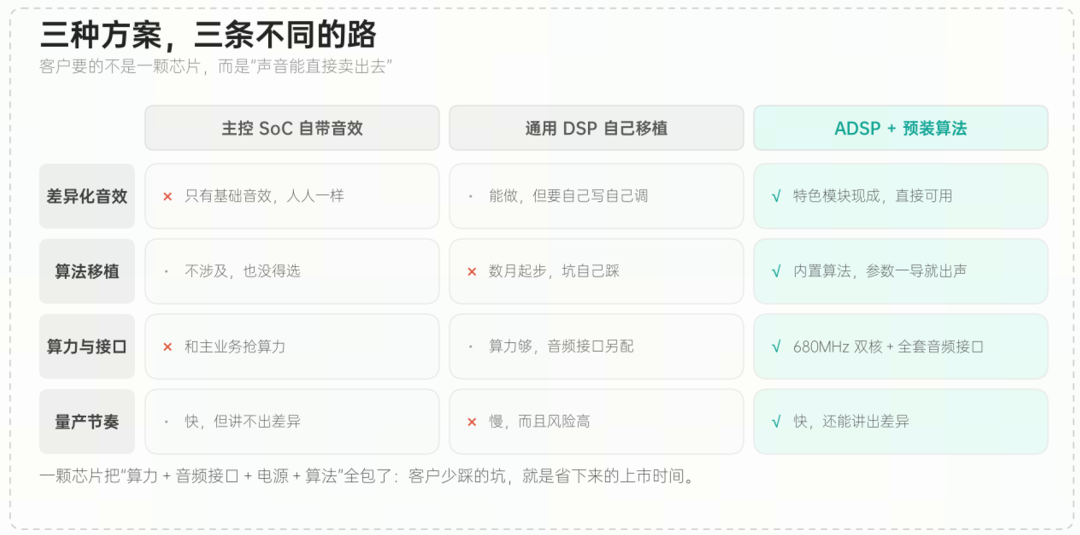
图十 三条路:主控 SoC 自带音效、通用 DSP 自己移植、ADSP 加预装算法
结语
声音这件事,用户从来不谈算法、信噪比和声道数。他们只会说三句:听不清、太吵了、声音发闷;背后是上千个参数和一颗芯片的通力协作。
从“能听见”到“听得清”,再到“听得爽、听得自然”,方向一直是同一个:把复杂留在芯片里,把简单交给用户。
下一步,上行与下行还会继续融合:AI 降噪、定向波束、声源定位、远场与语音唤醒会成为标配;再往后,声纹、多模态与大模型 ASR 会把“听得懂”一并解决。AW 从音频 PA、Codec 到车载音频总线、ADSP 与 NPU 的全链路布局,就是让这些算法不必再为“跑不动”而妥协。所以下次觉得声音不好听时,先别急着怪喇叭。