10月15日,Databricks在官方博客发布工程实测文章《Sizing Lakebase Search:Lessons from a Real App and 4 Million Passages》,以公司内部应用Slide Hub与MIRACL英文语料100万至400万段落规模为测试基准,系统给出了Lakebase Postgres向量与BM25混合检索的容量规划方法与成本基线。测试显示,将文件缓存规模与向量索引规模对齐后,页面缓存命中率可达95%~98%,热向量查询延迟最低降至4毫秒;候选池从1000缩减至200仍保留90.5%的Top-10检索结果;14分钟压测完成109602次请求且零错误,数据库侧成本仅0.02美元。检索增强生成(RAG)已成为大模型应用落地的事实架构,但对工程团队而言,检索层"算力买多大、索引建多大、候选取多少"长期缺乏量化依据,这份报告试图把这些问题变成可计算的算术题。
一、测试基准:真实内部应用叠加400万段落公开语料
Slide Hub是Databricks内部使用的演示文稿检索应用:一线工程师以自然语言与关键词在海量幻灯片中查找内容,系统同时通过MCP服务接口向AI智能体开放检索能力。该应用承载约700个演示文稿、约2.3万行幻灯片数据,全部运行在无服务器形态的Lakebase Postgres上——幻灯片、投票、遥测数据与两套检索索引同库存放,官方强调这正是"一个数据库承载一个应用全部状态"的典型样本。
公开语料方面,测试团队选取源自维基百科的MIRACL英文数据集(代码Apache-2.0许可、段落遵循CC BY-SA),使用gte-large-en-v1.5模型(1024维向量)完成嵌入,分别构建100万、200万与400万段落三档测试集(完整语料约3289万个段落)。三档规模对应的向量索引体积分别为5.8GB、11.5GB与23.0GB;在8 CU算力下,以二进制COPY方式加载400万行数据仅耗时19分钟。嵌入环节的成本也被量化:单张A10G GPU以每秒379个段落的速度处理400万段落约需2.95 GPU小时,若改走模型服务端点完成同样的嵌入则需花费48.87美元。
二、容量规划方法:把文件缓存"对齐"到向量索引规模
这份报告最具复用价值的,是一个可迁移的容量规划指标——缓存比,即本地文件缓存规模除以向量索引规模。Lakebase Postgres每1 CU约提供1.6GB本地文件缓存(最高可占计算内存的75%),因此缓存比本质上回答了一个问题:算力买多大,才能把索引"装进内存"。
实测数据显示:当缓存规模仅为索引规模的0.07倍时,页面缓存命中率为45%;提升至0.57倍时命中86%;达到1.14倍、索引恰好完整装入缓存时,命中率升至97%。Databricks据此给出经验法则:让缓存规模与索引规模匹配,无论语料是200万还是400万段落,命中率都能稳定在95%~98%——两档规模的实测曲线几乎重合,意味着该方法不随数据量增长而失效。
【图表:缓存规模与索引规模之比对页面缓存命中率的影响】
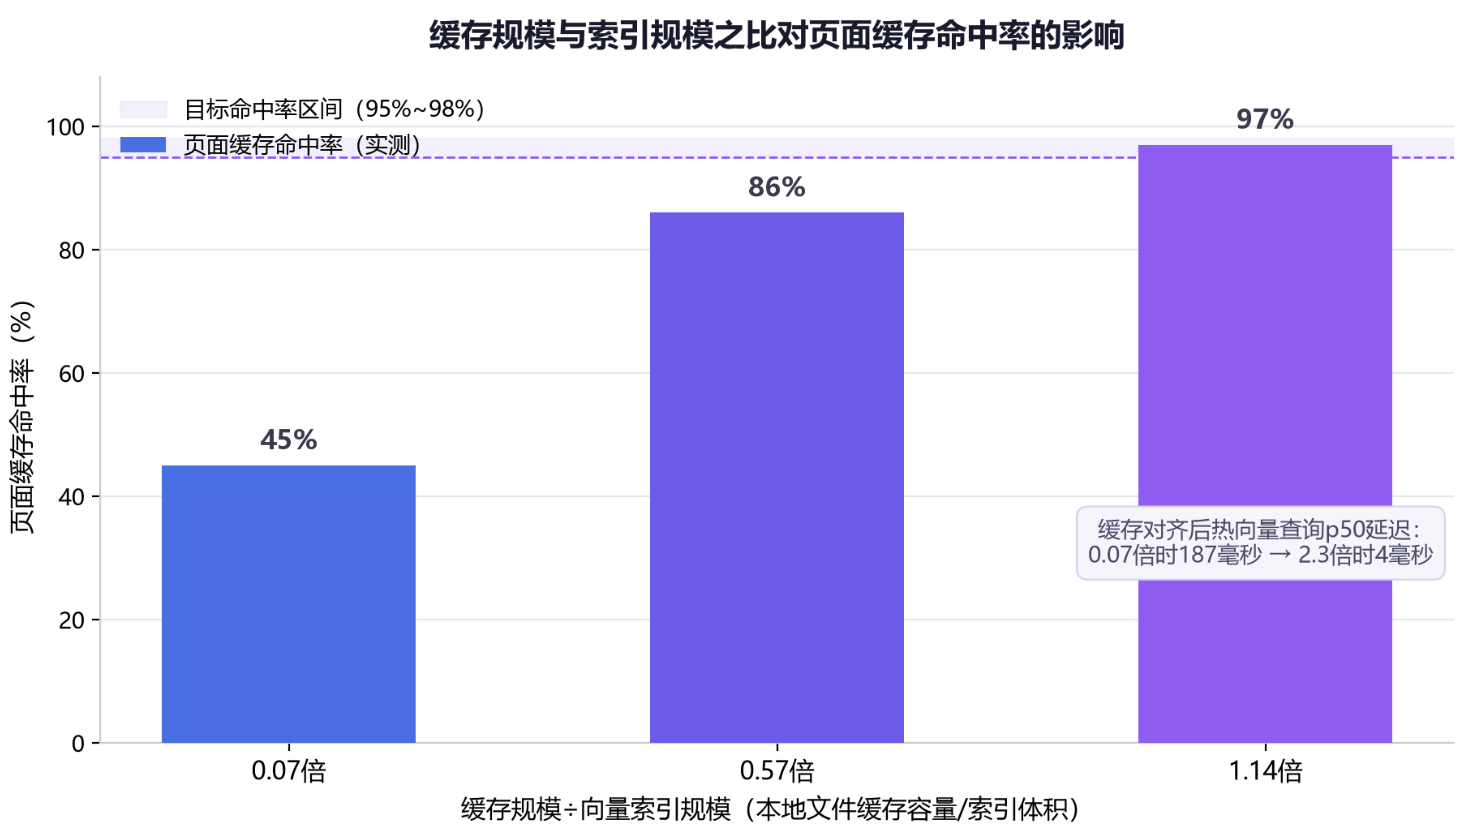
页面缓存命中率随缓存比提升呈阶梯式跃升,从0.07倍的45%升至1.14倍的97%。工程含义明确:容量规划的第一步是先确认向量索引体积,再按缓存比约1倍反推所需CU数量,即可让绝大多数查询不再触碰远端存储。
三、延迟表现:热向量查询最低4毫秒,缓存未命中代价约0.3毫秒
缓存命中率的提升直接兑换成了延迟收益。热向量查询p50延迟在0.07倍缓存比时为187毫秒,缓存比提升至2.3倍后降至4毫秒,进入个位数毫秒区间;混合检索对缓存更为敏感,缓存不足时维持在800毫秒左右,缓存比超过约1倍后骤降至33毫秒。
报告还量化了每一次缓存未命中的代价:每未命中一个8KB数据页,向量检索约增加252微秒、混合检索约增加316微秒,平均约0.3毫秒。当缓存比约为1倍时,从100万到400万段落,热向量查询稳定在11~23毫秒、热混合查询约276毫秒;冷查询则随语料规模增长——向量检索从100万段落的44毫秒增至400万段落的133毫秒,400万段落下的冷混合查询约911毫秒。
四、候选池减配:从1000降到200,Top-10结果保留90.5%
第二组实验回答了检索质量与算力开销的权衡问题:向量检索的候选池规模能砍多少?团队将每路检索的候选池上限分别设为40个、100个、200个与1000个四档,并以1000候选的结果为基准比对Top-10重叠率。
结果显示:候选池40个时Top-10重叠率为74.5%,100个时为89%,200个时为90.5%,1000个时为100%。代价的另一面是延迟与资源消耗:候选池200个时,重复查询p50延迟11.7毫秒、冷查询387毫秒、触达10401个数据页;候选池1000个时,三项分别为35.3毫秒、740毫秒与28972个数据页。40档的重复查询延迟虽低至5.0毫秒,但74.5%的重叠率已难以保障检索质量;100档重复查询为7.9毫秒。综合来看,200候选以约三分之一的数据页触达量保住了九成以上结果,是报告认可的工作点——200候选下的端到端冷检索为2.9秒(含约1秒的服务端点唤醒),重复查询约40毫秒。
【图表:候选池规模对Top-10结果重叠率与重复查询延迟的影响】
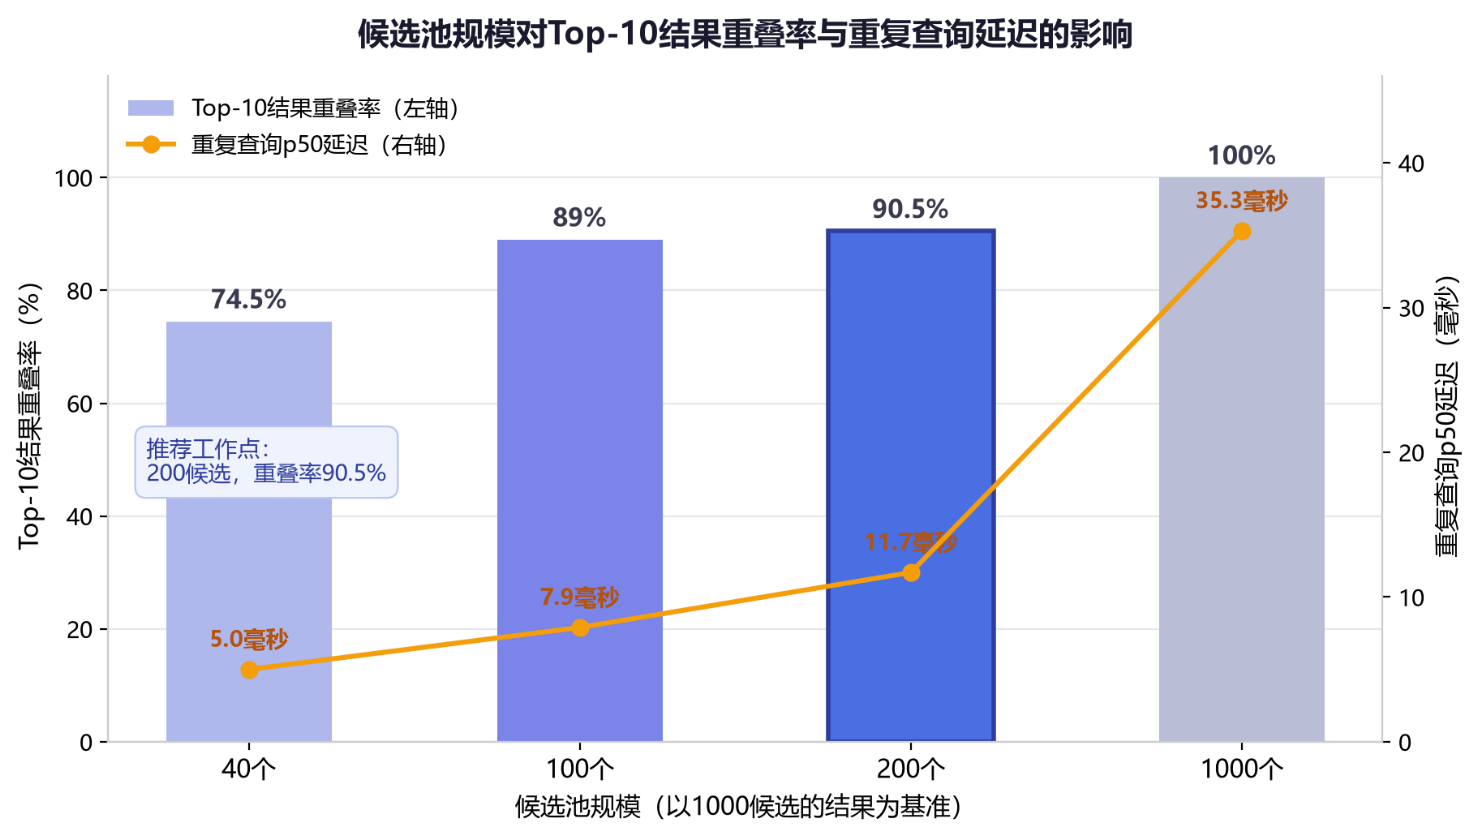
候选池从1000个降到200个,Top-10重叠率仅下降9.5个百分点,重复查询延迟却从35.3毫秒降至11.7毫秒;继续降到100个可再省延迟,但重叠率跌破90%。对成本敏感的在线服务,这是一条可直接套用的"质量—时延"权衡曲线。
五、检索实现:一条SQL完成向量与BM25混合检索,召回率最高0.97
在实现层面,Lakebase Postgres通过两个扩展提供混合检索能力:lakebase_vector提供带IVF分区与RaBitQ量化的近似最近邻索引,量化后约每维1比特,索引体积约为float32的1/32;lakebase_text提供BM25全文检索。两路检索结果经倒数排序融合(RRF,k=60)合并,再施加0.70相似度门槛、标题分层加权与权限过滤——整个过程由一条SQL语句完成,一次连接、一次提交,无需在数据库与独立向量库之间搬运数据。单个索引可支持超过10亿向量。
召回率方面,以精确检索为基准:默认构建下,默认探针数109时Recall@10为0.74~0.75(延迟3毫秒),探针数提高至2000可达0.95(49毫秒);改用quality模式构建索引后,默认探针数即达0.80,500探针为0.91(13毫秒),2000探针达0.97(约50毫秒),该索引在16 CU下构建耗时52分钟。
六、压测与成本:14分钟10.9万次请求,数据库侧仅0.02美元
压测给出了一份细颗粒度的成本账。吞吐方面:1 CU算力搭配MEDIUM规格应用(2 vCPU、6GB内存)每秒处理196个请求(p50延迟1.8秒);8 CU时每秒336个请求(p50延迟1.0秒);16 CU搭配LARGE规格应用(4 vCPU、12GB内存)吞吐不低于每秒662个请求(p50延迟343毫秒,此时瓶颈在压测端而非数据库)。工程细节上,引入连接池后吞吐从每秒45个请求提升至85个请求,p95延迟从2.4秒降至0.7秒。
成本方面:14分钟同区域阶梯压测完成109602次请求、零错误,消耗0.21 CU小时,其中Lakebase Postgres数据库侧仅花费0.02美元,加上应用侧合计0.13美元。计价口径为1 CU小时对应0.213 DBU,AWS美东区Premium合约约0.085美元、Enterprise合约约0.11美元。据此Databricks建议:生产环境常驻0.5 CU以规避约1秒的冷启动,月成本约31~40美元(按Premium单价约31美元、Enterprise单价约40美元);开发测试环境可缩容至零。Lakebase的弹性区间为自动扩缩0.5~64 CU(上限不超过下限加16 CU)、固定规格最高112 CU;在整个Slide Hub的30天账单中,数据库仅占约1%。
【图表:不同算力配置下的压测吞吐量对比】
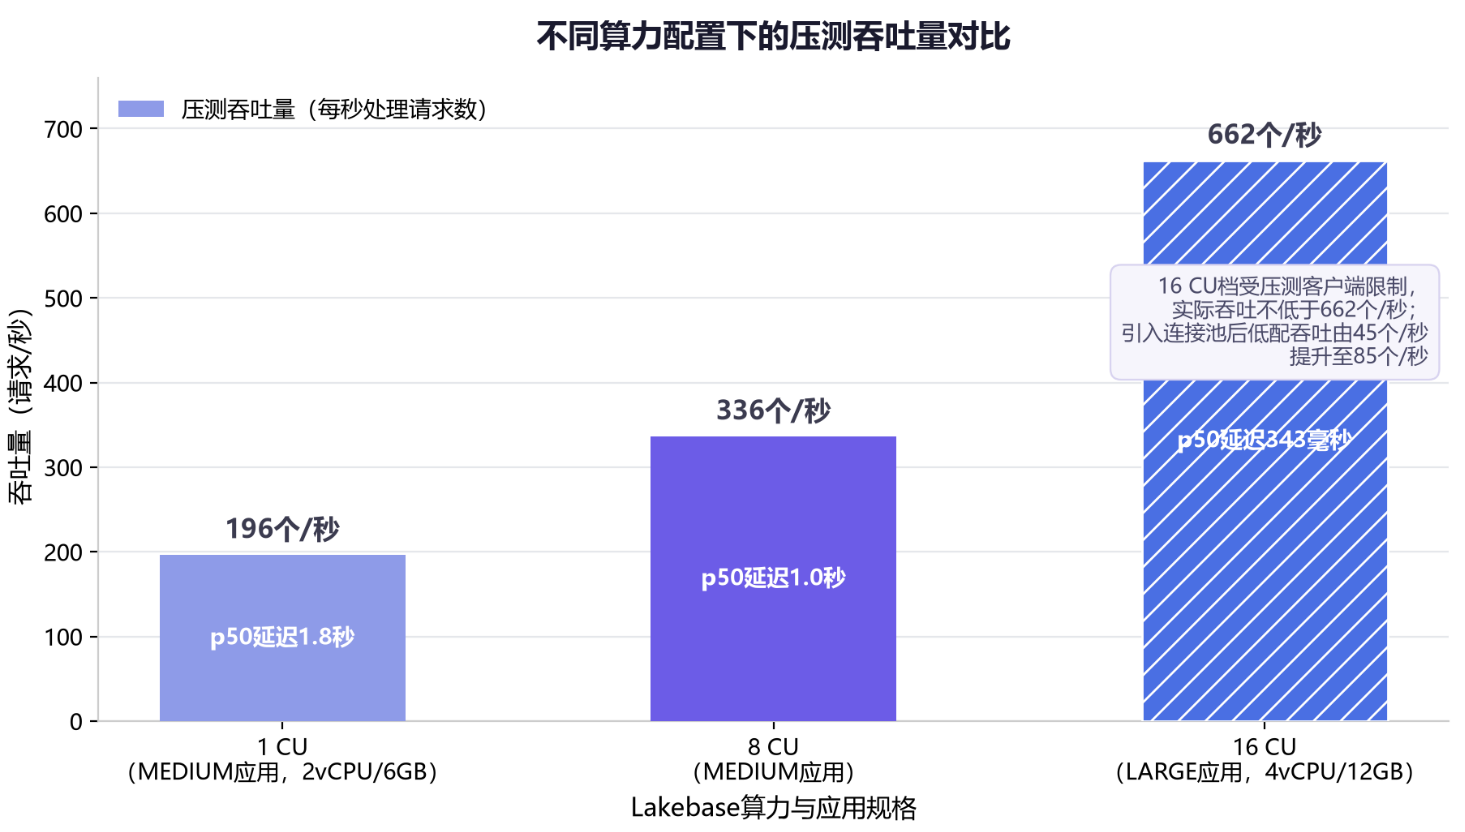
吞吐量随算力档位提升而增长,1 CU到16 CU从每秒196个请求提升至不低于662个请求;连接池等软件层优化在低算力区间收益显著(每秒45个提升至85个)。对多数RAG应用而言,数据库侧成本并非主要矛盾,应用侧算力与冷启动策略更值得规划。
七、行业观察:RAG检索层选型从经验判断走向量化规划
这份报告的产业背景,是检索层正在成为RAG与AI智能体应用的成本与性能焦点。国内产业侧的观察与此呼应:致远互联在2025年年报中披露,其RAG知识库构建系统在检索层采用向量数据库结合BM25关键词检索的混合策略以提升召回率,但实时性检索与动态知识更新的效率仍是规模化应用的瓶颈;开发者社区的实战总结亦强调,RAG系统搭好之后"怎么让它跑得又快又省才是生产级的关键",生产环境常见选型包括Chroma、Pinecone与pgvector等。
数据库厂商正把混合检索能力内置到产品内核。国盛证券2026年7月研报显示,达梦数据推出的GDMBASE V4.0图数据库面向10亿规模点边向量与图混合数据场景,检索响应时间低于500毫秒、检索召回率提升30%、大模型幻觉率降低60%,其AI长效记忆系统在100万语义子图规模下检索延迟低于100毫秒。
Databricks的路线一脉相承:此前宣布收购无服务器Postgres厂商Neon,Lakebase基于开放湖存储提供无服务器Postgres服务,其技术论文已发表于数据库顶会PVLDB 2026,Azure官方文档已上线Lakebase Postgres专页;国内技术社区将2026年6月Databricks推出LTAP架构、Lakebase向事务能力延伸视为"湖库一体"演进的代表案例,数据基础设施领域甚至出现了"Vector Lakebase"的产品化讨论。与独立向量数据库方案相比,"事务、向量、全文检索同库"减少了数据搬运与组件维护成本——中文开发者社区对PostgreSQL与pgvector、BM25路线的成本拆解亦得出类似结论:复用现有Postgres许可可省去独立向量库的授权与新增集群节点开销,并提醒团队避免"一上来就奔Elasticsearch、Milvus"的选型惯性;有行业分析进一步指出,向量数据库已成AI推理侧的刚需组件。Neon的开发者指南同样将关键词与向量混合检索加RRF融合列为智能体检索蓝图的组成部分。
对照来看,这份实测的真正价值不在具体数字,而在方法:缓存比对齐决定内存命中率,候选池规模决定质量与算力开销的平衡点,冷启动与常驻成本核算决定部署形态——三者构成了一套可复用的检索层容量规划框架。对仍依赖"经验拍脑袋"的工程团队而言,这份报告把检索层选型从感觉问题变成了算术问题。