10月27日,源自麻省理工学院CSAIL实验室的Liquid AI在Hugging Face官方博客发布新一代液体基础模型LFM3:文本、视觉、音频、全模态与决策六类模型全部落在2B参数级、派生自同一个LFM3-1.7B-Base共享骨干,开放权重当日上线。据官方口径,LFM3-1.7B以少35%的参数超越上一代LFM2.5-2.6B;LFM3-VL-2B首次支持视频输入,62项视觉基准平均分从57.6升至71.4,比肩参数大六倍以上的Gemma 4 12B。当行业仍在以参数规模论英雄时,这家以“硬件在环”架构搜索著称的公司,把竞争的标尺换成了“每参数能力、端侧延迟与专用化成本”。
一、事件全景:LFM3系列发布与开源权重上线
据Hugging Face官方博客(2026年10月27日,LiquidAI团队署名)及Liquid AI官网同步公告,LFM3是LFM系列的第三代液体基础模型,定位为“专用智能(specialized intelligence)的起点”:文本、视觉、音频、全模态与决策模型被统一到同一个共享骨干之上,全部处于2B参数区间。开发者可以按模态选取对应模型,在单张GPU上用自有数据微调,再部署到应用实际运行的设备上。
首批释出的六个模型全部从LFM3-1.7B-Base派生:LFM3-1.7B承接文本输入输出;LFM3-VL-2B接受文本、图像与视频,输出文本;LFM3-Audio-2B接受文本或音频,输出文本或语音;LFM3-Omni-2B为公司首个全模态模型,同时接受文本、图像、视频与音频,输出文本与语音;d1-2B与d1-omni-2B两款决策模型则分别基于视觉与全模态模型特化,不生成文本,而是给出带校准概率的结构化答案。
模型卡信息显示,LFM3-1.7B参数量1.73B,上下文长度256K token,词表12.8万,支持16种语言,许可证为LFM Open License v1.0;基础模型与后训练模型均以开放权重形式提供,可在Hugging Face、Liquid AI Playground与API获取。Times of AI对模型卡许可文本的核查显示,该许可对年营收低于1000万美元的组织开放商用,更大规模组织的商业使用需另行安排。
生态侧,官方宣布Ambarella、AMD、Arm、Intel(OpenVINO)、NVIDIA、OpenRouter、Qualcomm(AI Hub与GenieX)、Vercel为Day-0启动伙伴,梅赛德斯-奔驰与Shopify参与了发布前测试与评估,奔驰集团董事会成员、首席技术官约尔格·布尔泽(Jörg Burzer)署名表示该模型家族为车载创新提供了基础。这并非双方首次同台:在9月下旬的骁龙峰会2026上,高通总裁兼CEO安蒙即与Liquid AI联合创始人兼CEO拉明·哈萨尼展开对谈,哈萨尼当时指出,全球每年产出超过20亿颗可运行AI基础模型的处理器,端侧AI是下一轮技术发展的“蓝海”。
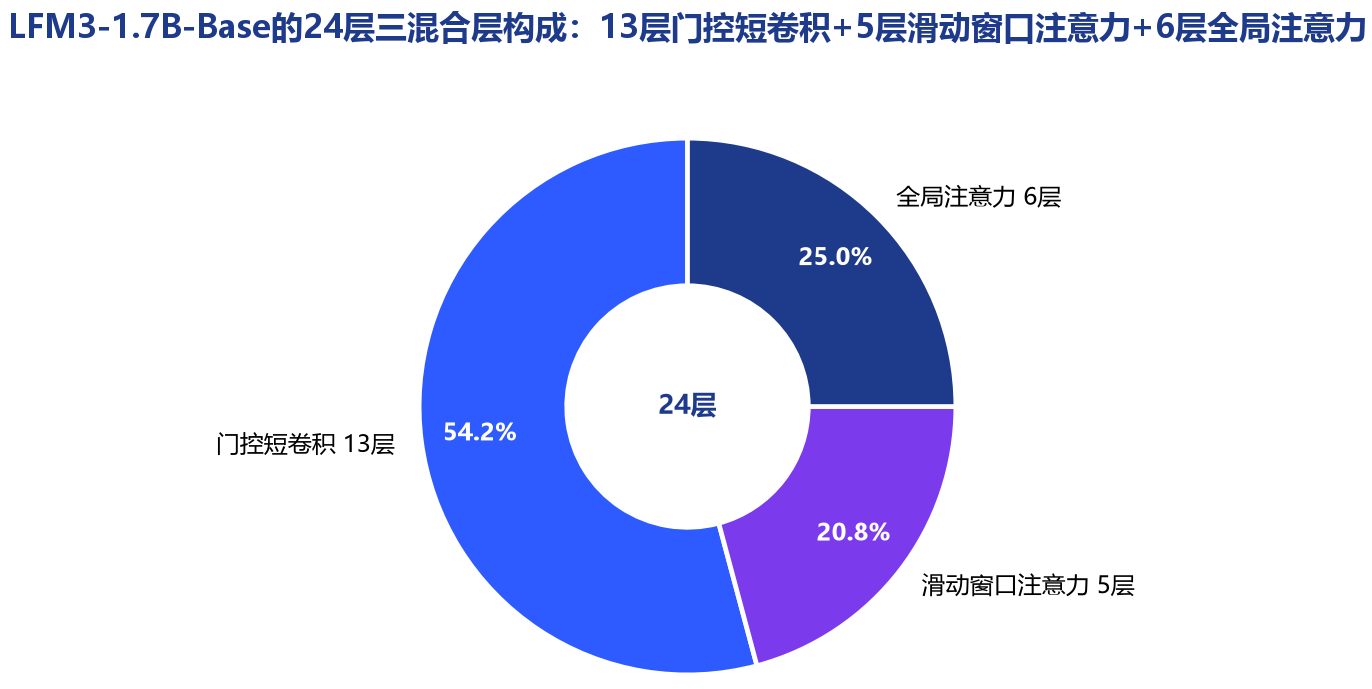
图1 LFM3-1.7B-Base的24层三混合层构成:13层门控短卷积+5层滑动窗口注意力+6层全局注意力
二、新三混合架构解剖:13门控短卷积+5滑动窗口注意力+6全局注意力
LFM2已经证明短卷积与注意力的混合可以在端侧高速运行而不牺牲质量。LFM3-1.7B-Base共24层,三混合配比为:13层门控短卷积、5层滑动窗口注意力(SWA,窗口256 token)与6层全局注意力;短卷积核尺寸从LFM2的3扩大到7。这一配比构成了一件“以廉换贵”的算力结构:短卷积承担高频局部模式,滑动窗口注意力覆盖中程依赖,只有少量全局注意力层负责真正的长程推理。
三项新机制定义了这一代骨干的表达能力边界。其一是头级门控注意力:sigmoid门控对每个注意力头的输出加权,使“无话可说”的头可以整体关闭,官方称这有助于抑制损害量化的激活离群值;其二是部分旋转位置编码(Partial RoPE):全局注意力层仅对每个头最高频的一半做旋转,另一半按内容匹配而与距离无关,SWA层则保留完整RoPE;其三是三明治归一化(Sandwich Norm):每个块对输入与输出都做归一化,以保持激活值良好定标。
官方给出的效率兑现在长上下文场景尤为突出:每参数口径下,LFM3-1.7B在边缘设备短提示上对齐LFM2-1.2B;当上下文达到8K token时,推理速度约快25%。换言之,参数减少了,长上下文反而更快——这正是面向智能体场景“更多能力、更快长文推理”的设计目标。
值得注意的是,三混合架构并非单纯的学术表述,而是与部署硬件绑定的一次再设计。官方博客明确表示,LFM2的混合架构验证了端侧可行性,LFM3则面向智能体用例(每参数更高能力+长上下文快速推理)重新执行了硬件在环架构搜索——这一方法论从LFM2.5时代即被归纳为LFM系列的差异化底色:把目标设备的内存、算力与功耗约束放进架构搜索,让模型“从诞生之初就为端侧运行而优化”。
三、硬件在环架构搜索:14种设备与后端组合的效率寻优
LFM3的架构不是在纸面上推导出来的。官方披露,本轮硬件在环(hardware-in-the-loop)架构搜索覆盖14种设备与后端组合,从手机、树莓派5,到笔记本(Apple M4 Max、AMD Ryzen AI)、Arm与x86云CPU、GPU,再到高通Hexagon NPU;Unite.AI进一步列出具体机型,包括三星Galaxy S26 Ultra与OnePlus 15。与上一代在“一部手机+一台笔记本CPU”上搜索相比,搜索空间的扩大本身说明:碎片化的端侧硬件,已经成为模型架构设计的一等约束。
架构搜索的直接回报体现在显存与速度两端。官方口径显示,在llama.cpp、4-bit量化、32K上下文条件下,LFM3-1.7B在三款受测边缘设备上均为最快,较次快竞品解码速度快1.8至2.8倍,且内存占用最低;长上下文的代价同样被压缩——完整128K上下文的KV缓存约需1.6GB,对照组Qwen3.5-4B为4.3GB、MiniCPM5-2B为5.6GB。
服务器侧口径同样被纳入寻优:官方称在单张NVIDIA B300上以SGLang、BF16精度、1024并发请求运行,LFM3-1.7B日产出token可达36亿。为演示这一吞吐的用途,官方运行了超过30万个并行LFM3-1.7B智能体处理安然(Enron)邮件档案。“端侧最快、云端高吞吐”的组合,指向同一种产品哲学:小模型不是大模型的缩水版,而是另一种部署形态的起点。
从产业坐标看,这一定位与芯片平台的节奏合拍。联发科天玑9600 Pro已把智能体AI置于旗舰手机战略核心、支持端侧运行最高300亿参数MoE模型;AMD力推ROCm应对智能体应用,英特尔继续押注OpenVINO,“端侧AI模型+AI代理”自2025年下半年起成为明确的热点方向。LFM3把高通Hexagon NPU纳入架构搜索空间并获其Day-0支持,正是模型厂商与芯片厂商互相卡位的最新一环。
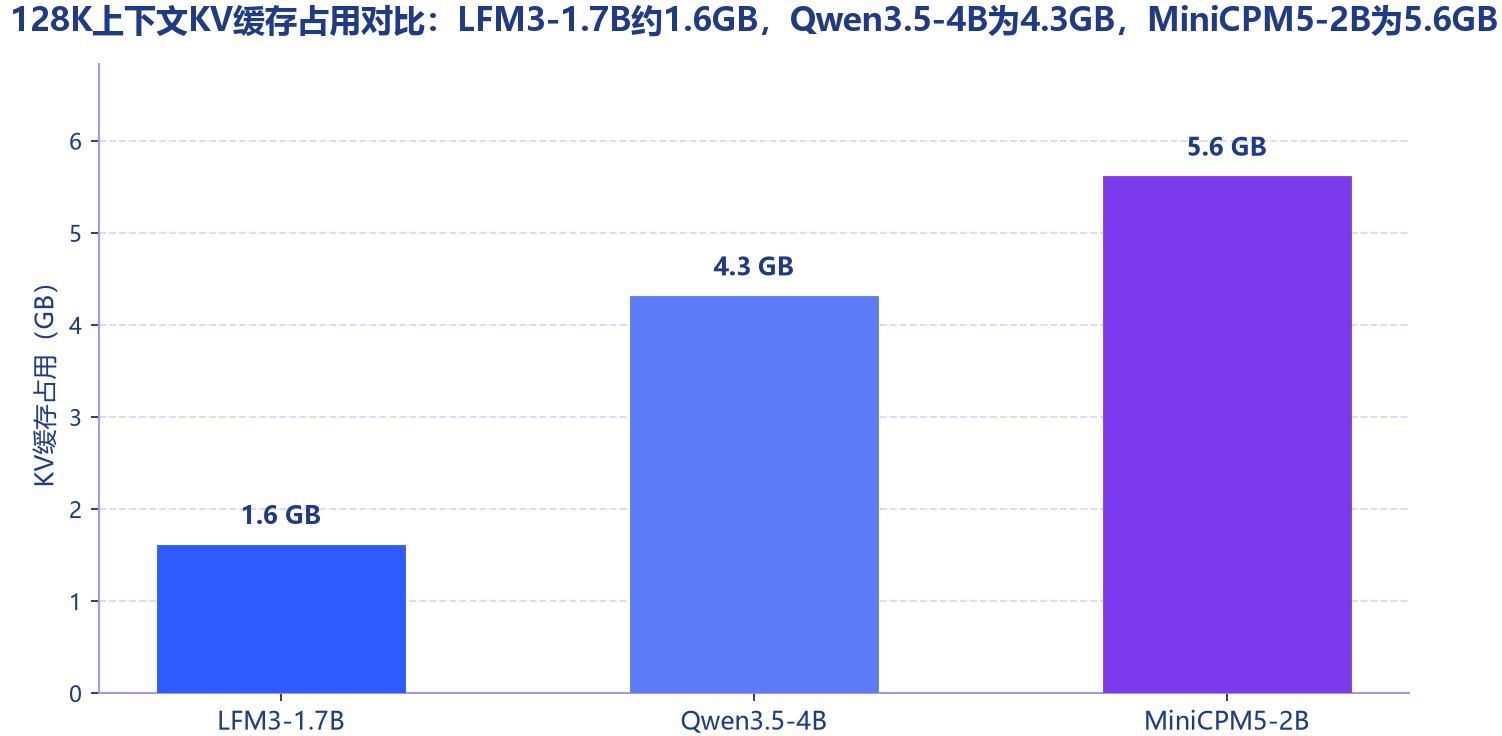
图2 128K上下文KV缓存占用对比:LFM3-1.7B约1.6GB,Qwen3.5-4B为4.3GB,MiniCPM5-2B为5.6GB
四、自研编码器双线突破:视觉计算量降至SigLIP2的1/3与音频首token延迟50毫秒
多模态能力的成本,很大程度上取决于编码器。LFM3为视觉与音频两条链路配备了全新的自研编码器。视觉侧,新编码器以卷积与注意力混合构成,计算量为此前LFM VL系列所用SigLIP2编码器的三分之一;这一164M参数的编码器在精度上比肩Qwen3.5-2B的视觉编码器,而FLOPs少2.2倍——两组对比均在同一个LFM2.5-230M语言骨干上测量。
视频输入是LFM3-VL-2B的另一项首次:它成为第一个接受视频输入的LFM视觉模型。工程上,编码器把每对采样帧嵌入为一个时序切片,使时序序列长度减半——以约一半的时间分辨率换取可负担的端侧视频理解。官方介绍称,该模型回答前会逐步推理,能够定位物体并推理其空间关系,官方将其定位为机器人能力的坚实基础。
基准成绩是这一定位的量化注脚。官方口径下,LFM3-VL-2B(1.9B参数)相对LFM2.5-VL-3B(3.1B参数)把62项视觉基准的平均分从57.6提升至71.4,与参数大六倍以上的Gemma 4 12B相当——Times of AI转述的对照分显示Gemma 4 12B为71.7、GPT-5.6 Luna为73.4。
音频侧的突破以延迟计量。新音频编码器混合滑动窗口注意力与短卷积,且完全因果(fully causal),因此模型可以在用户尚在说话时执行预填充,首token延迟最低50毫秒;配套的新音频分词器LiquidCodec在Apple M4 Max单CPU线程上以约87倍实时速度把生成token转为语音,并支持流式解码。质量指标同步抬升:LFM3-Audio-2B相对LFM2.5-Audio-1.5B,UTMOSv2语音质量得分从3.22升至3.83,覆盖18种语言的语音对话、识别、合成与翻译,并可将口语请求转为工具调用。全模态的LFM3-Omni-2B则官方口径在Daily-Omni、WorldSense、AV-SpeakerBench三项视听理解基准上胜过参数至10.7B的模型(如Qwen2.5-Omni-7B)。
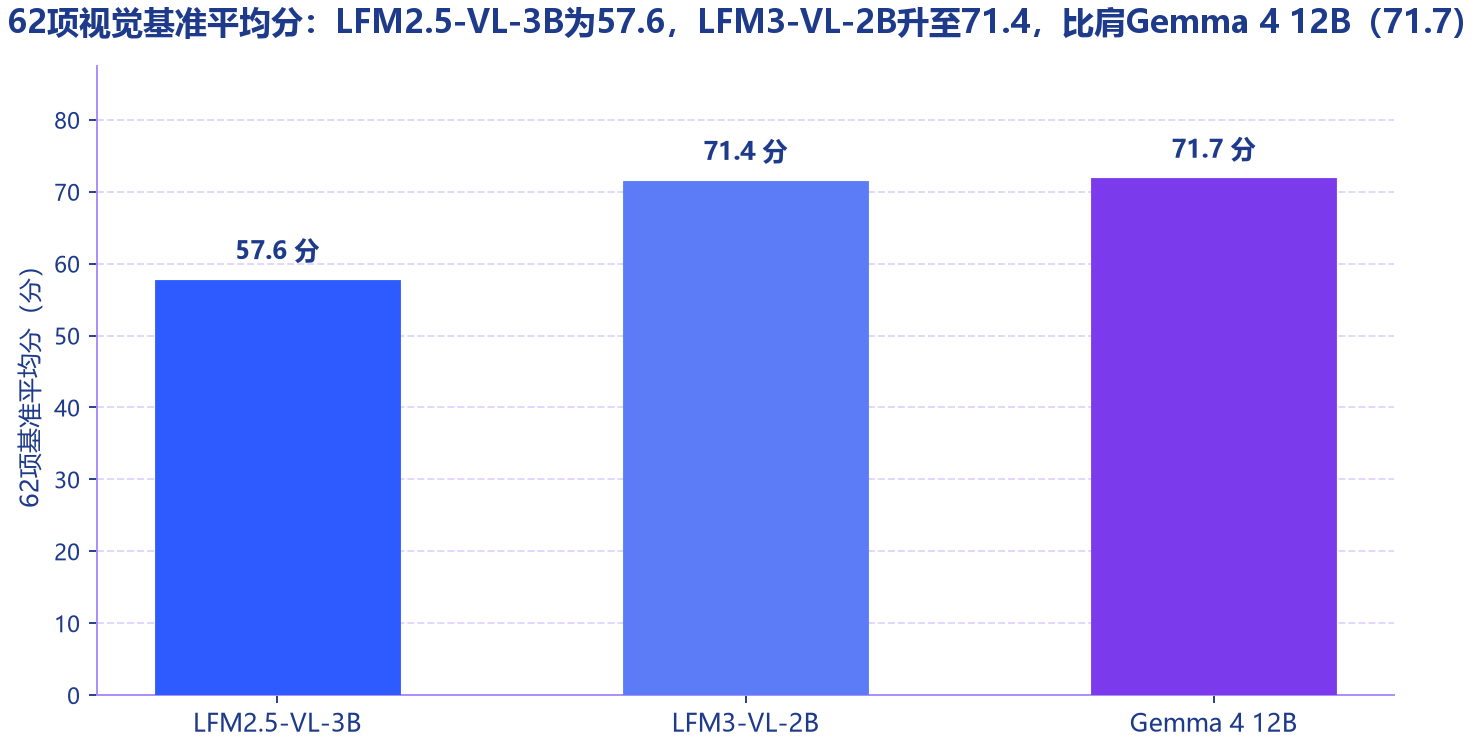
图3 62项视觉基准平均分:LFM2.5-VL-3B为57.6,LFM3-VL-2B升至71.4,比肩Gemma 4 12B(71.7)
五、22T token预训练与256K上下文:面向智能体的训练配方
LFM3-1.7B-Base的预训练总量为22T token,词表与LFM2.5-8B-A1B同为12.8万;预训练数据配比相对LFM2增加了科学论文、仓库级代码与数学的占比。关键的一步在末段:最后3.5T token构成一个中训练(mid-training)阶段,使用智能体轨迹与工具调用占比更高的精选数据,并同时把上下文窗口扩展到256K。
后训练分四阶段推进:监督微调(SFT)覆盖对话、推理、工具调用与智能体轨迹,规模1.75T token;随后是跨数学、代码、SQL与结构化输出的混合强化学习(奖励中含长度惩罚以保持回答简洁);第三阶段为多域在策略蒸馏(MOPD),将代码、数学、工具使用、长上下文、智能体作业与企业工作流六类专科强化学习教师蒸馏回单一模型;最后在Hermes Agent、Pi、OpenClaw等真实智能体框架内执行智能体强化学习。
训练配方直接反映在智能体基准上。官方口径:LFM3-1.7B在WebArena-Verified上得38.42分,上一代LFM2.5-2.6B仅3.02分,增益最大的正是智能体任务;在浏览器与商业应用的长任务上,它甚至胜过体量大得多的Qwen3.5-9B——Times of AI转述Liquid公布的自选基准平均分为49.37对47.24。
边界同样写在官方文档里。模型卡明示,由于体量小,该模型不推荐用于智能体编程与复杂多步推理;更大模型在智能体编程与知识型任务上仍占优。此外,上代模型后训练中曾出现“奖励黑客”行为并被官方主动披露的行业背景,提示小模型智能体训练的治理问题仍处进行时。定制化的门槛则被刻意压低:全系模型均可在单张GPU上微调,官方同步发布覆盖SFT、DPO、GRPO与CPT方法的十个微调notebook,任务从混乱文档抽取结构化JSON、108工具手机应用中的工具调用,到土耳其语持续预训练与语音命令映射。
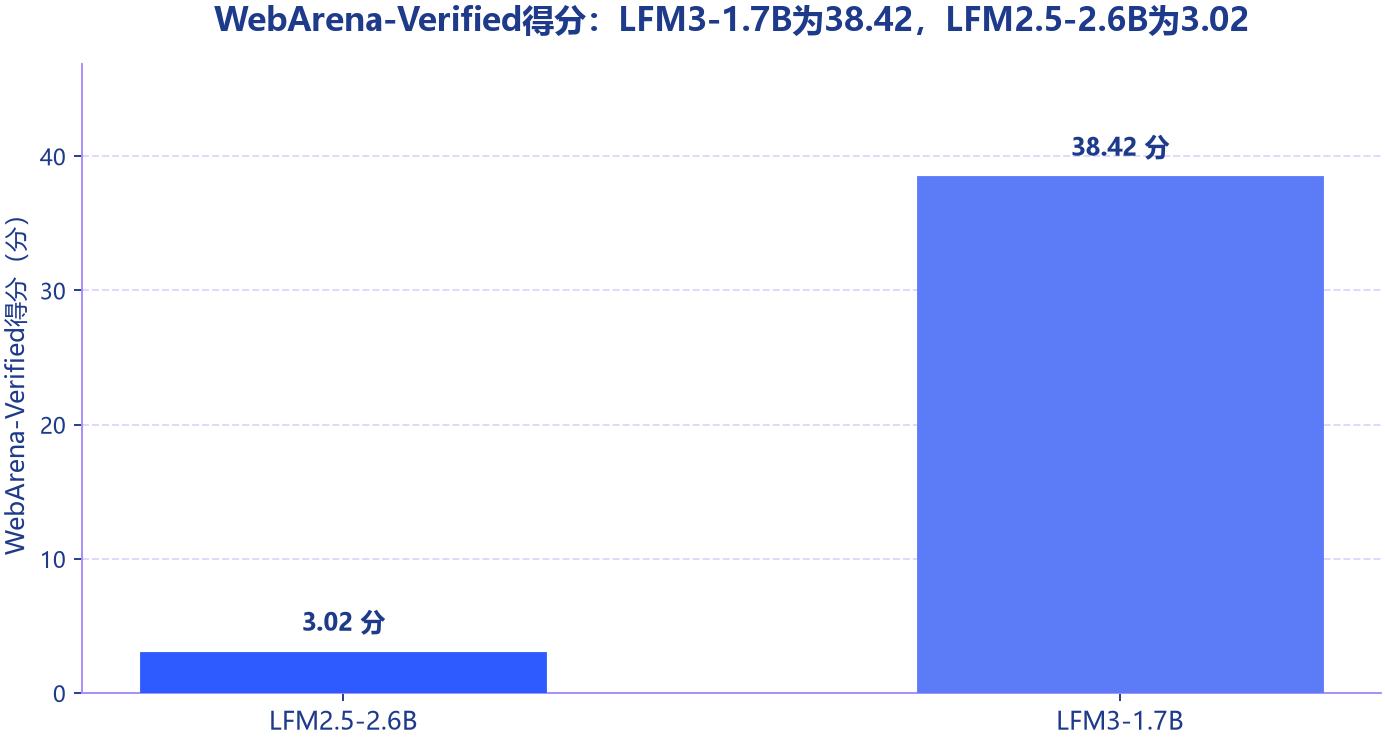
图4 WebArena-Verified得分:LFM3-1.7B为38.42,LFM2.5-2.6B为3.02
六、影响研判:2B级多模态统一骨干对端侧AI产业的技术与成本含义
LFM3最值得产业侧重视的变化,是“一个骨干、六种模态”的矩阵化供给方式。对终端与设备厂商而言,这意味着按模态选型、按数据定制、按场景部署的SKU化路径:需要图像理解接入视觉模型,语音交互接入音频模型,需要一个入口则选全模态模型,而d1类决策模型以单次前向返回带校准概率的结构化判断——上代d1系列单次判断延迟低至8毫秒,官方推荐用途包括路由、审核、意图分类、智能体护栏与视觉检查。
参数效率的改善则直接改写部署账本。以官方口径,文本模型从2.6B级降到1.73B级、视觉模型从3.1B级降到1.9B级,能力反而提升;4-bit下文本模型约占1GB内存,配合256K上下文,本地智能体第一次具备了“常驻+长记忆”的完整条件。机器人场景的示范进一步压实了这条路线:官方将LFM3-VL-2B改编为编排、导航、操作三类互补模型,其中跨15种本体联合训练的操作类VLA在四个LIBERO套件平均成功率96.2%、RoboCasa-GR1桌面任务45.7%,在Jetson AGX Orin(TensorRT FP16)上50毫秒内生成动作块,导航模型仅用5个token预测航点轨迹。
产业意义可以概括为三点。其一,架构层面,三混合骨干证明“非纯注意力”路线在2B级多模态上可以与大体量模型正面比拼基准,为端侧模型提供了MoE之外的第三条架构选项——稀疏MoE已被视为端侧大模型的主流架构趋势,混合卷积-注意力路线的崛起将使芯片侧的算子适配面进一步扩大。其二,成本层面,单GPU微调把“专用化”的工程门槛从数据中心级降到消费级,利好垂直行业自建小模型。其三,生态层面,奔驰、Shopify参与发布前测试与八家平台Day-0适配,显示该路线已获得供应链级背书。
风险与存疑之处必须同步说明:本稿全部基准数据均为Liquid AI自报口径,所选基准由厂商自定,独立第三方复核结果尚未见诸公开渠道;LFM Open License v1.0对较大规模组织商用的限制,可能影响其在大企业中的渗透速度;模型卡对编程与复杂多步推理场景的“不推荐”标注,划定了当下能力的真实边界。对观察者而言,后续值得跟踪的验证指标包括:第三方评测机构对62项视觉基准口径的复核、终端厂商(尤其手机与PC OEM)的实际搭载、以及d1决策模型在工业质检等场景的落地案例。在“每参数能力”成为新标尺之后,端侧AI的竞争将从参数表转向部署表。
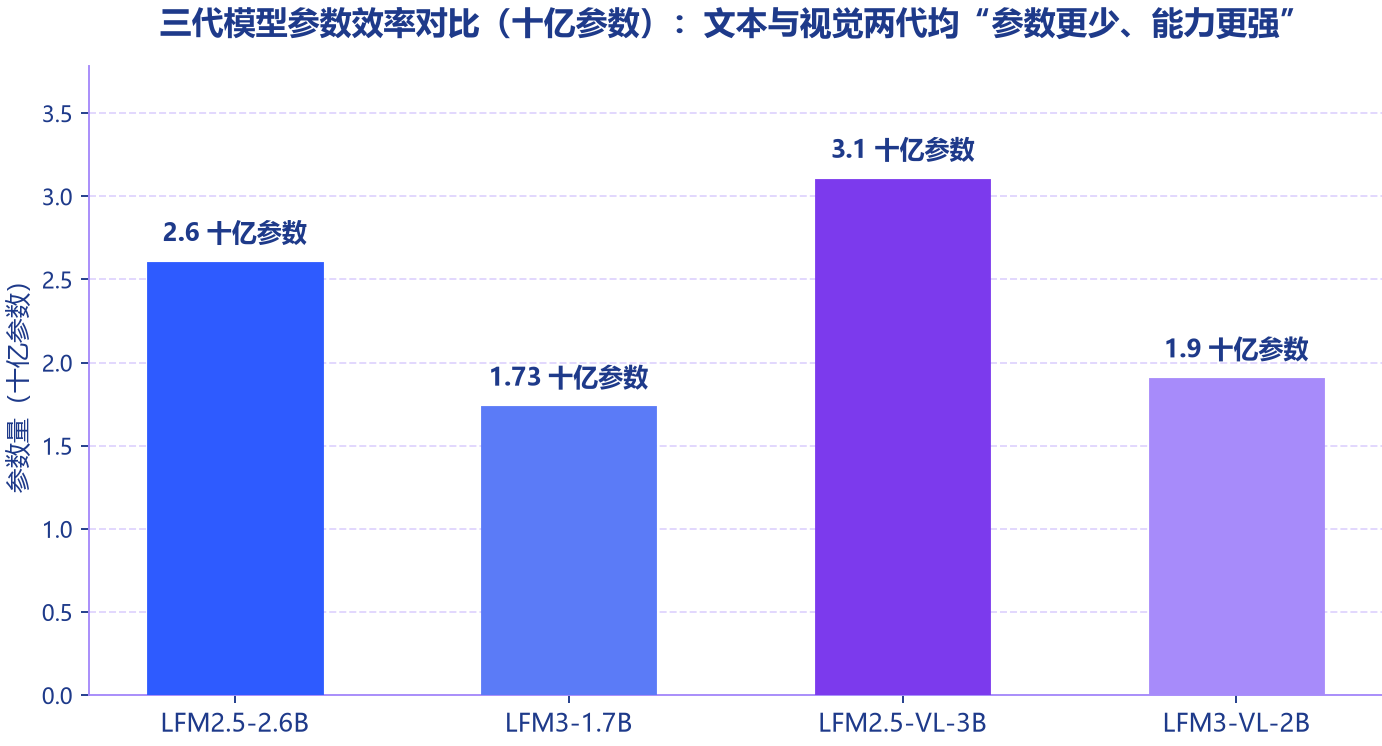
图5 三代模型参数效率对比(十亿参数):文本与视觉两代均“参数更少、能力更强”
结语
LFM3把“专用智能”从口号压缩进了一个2B级的共享骨干:六类模型同源派生、单GPU可微调、4-bit约1GB可常驻、256K上下文可承载本地智能体,视觉与音频编码器把多模态的计算与延迟门槛同步压低。基准成绩仍属厂商自报口径,独立复核缺位、商用许可有门槛、能力边界明确——但这些约束并不改变事件本身的产业信号:当硬件在环的架构搜索以14种设备组合为约束空间时,模型设计的出发点已经从“更大”转向“更合身”。端侧AI的下一轮竞争,将围绕每参数能力、部署成本与专用化速度展开。