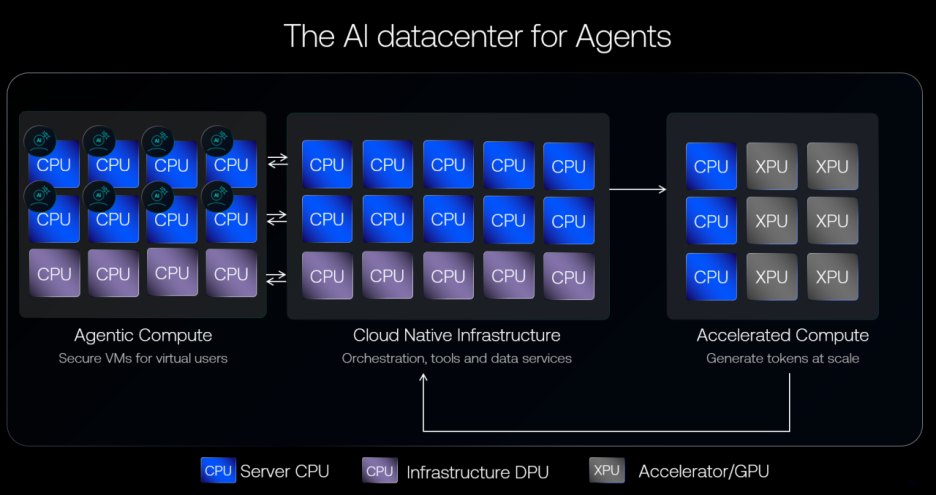
回看这三年AI基础设施的演进,很容易产生一种错觉,好像叙事完全由GPU书写。但数据中心里其实一直并行着两条主线——GPU把算力堆到极致,CPU让这些算力被喂饱、被调度、被真正用掉。两者从来同等重要,只是被看见的程度不同。
但伴随智能体时代的到来,当模型从“被训练”转向“被调用”,尤其是当智能体开始成规模地跑起来,真正被放量的是CPU,以及围绕CPU重新设计的机架、存储技术和开放软件栈。在AMD日前举办的“In Depth 2026”活动上,这家刚刚交出创纪录季报的公司,进一步阐释了其面向智能体时代的战略和布局。
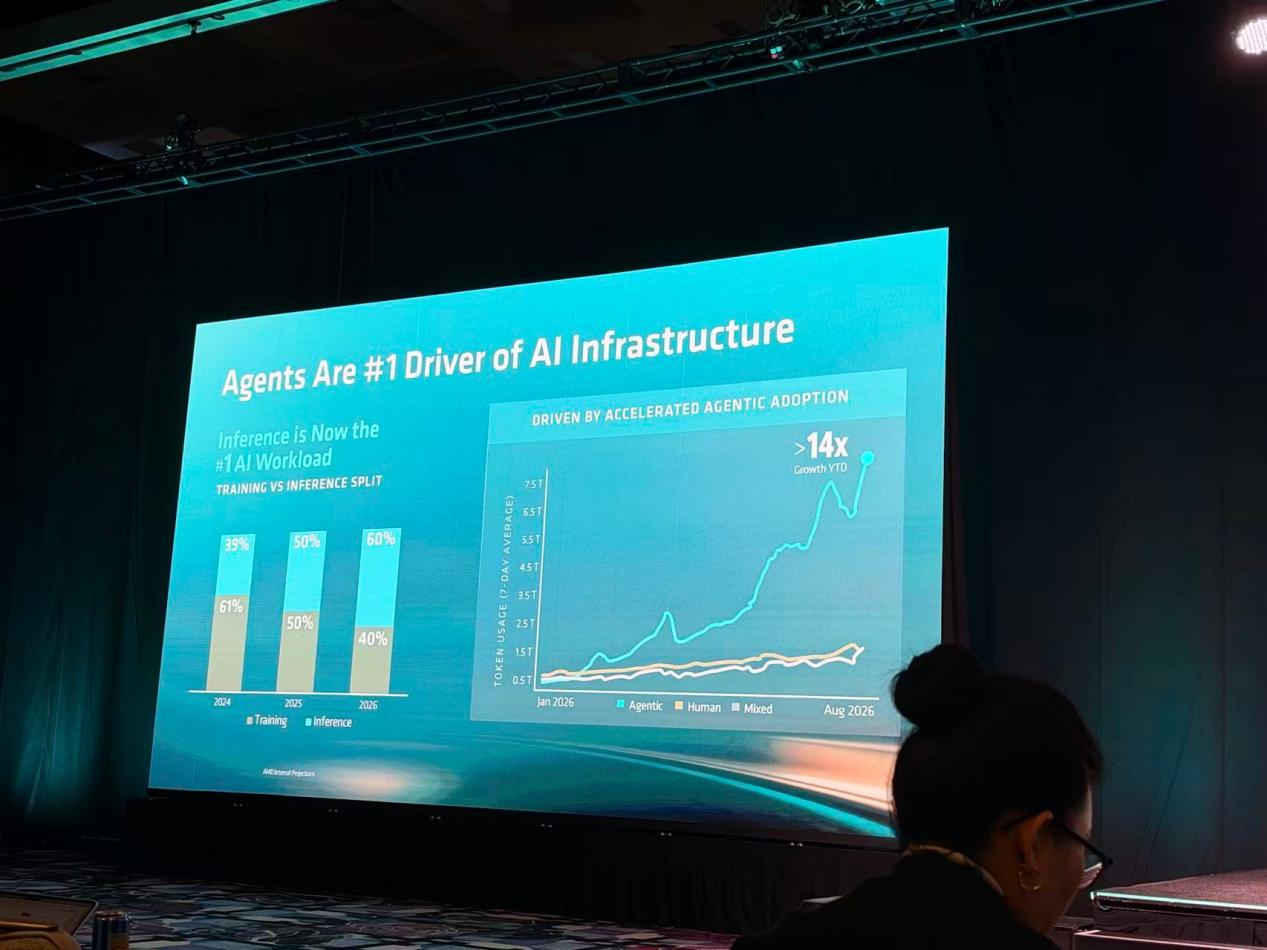
AMD的判断有三个支点。其一,负载结构变了:训练与推理的占比已从61%对39%翻转为40%对60%,智能体流量一年增长超过14倍,业界普遍预期CPU与GPU的配比将从1:4走向1:1。其二,成本结构变了:在DRAM现货价高企的年份,服务器成本故事由内存讲述。其三,竞争范式变了:NVIDIA用高度整合的封闭生态定义了AI工厂,AMD则选择用开放标准给出另一种答案。
此次活动中,第六代EPYC“Venice”、Helion机架,以及内存技术MEXT,正是AMD面对智能体时代AI基础设施的竞争而打出的三张王牌。
EPYC 9006 SP7出货,数据中心最强U
在本届In Depth 2026上正式登场的第六代EPYC(代号Venice,产品名EPYC 9006系列),基于全新Zen 6/Zen 6c微架构、采用2nm工艺,最高提供256核/512线程。
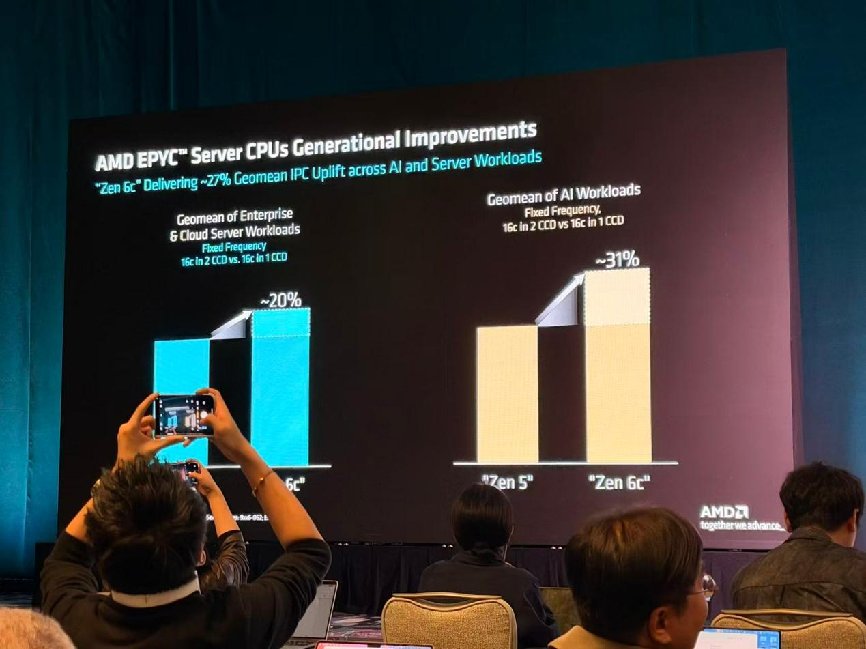
相对第五代Turin,Venice的综合IPC提升约27%(其中企业及云负载约20%、AI负载约31%),整数性能约2.0倍、浮点约2.4倍。
EPYC 9006系列包括四个家族式产品组合,针对不同AI数据中心的特征和场景量身定制。
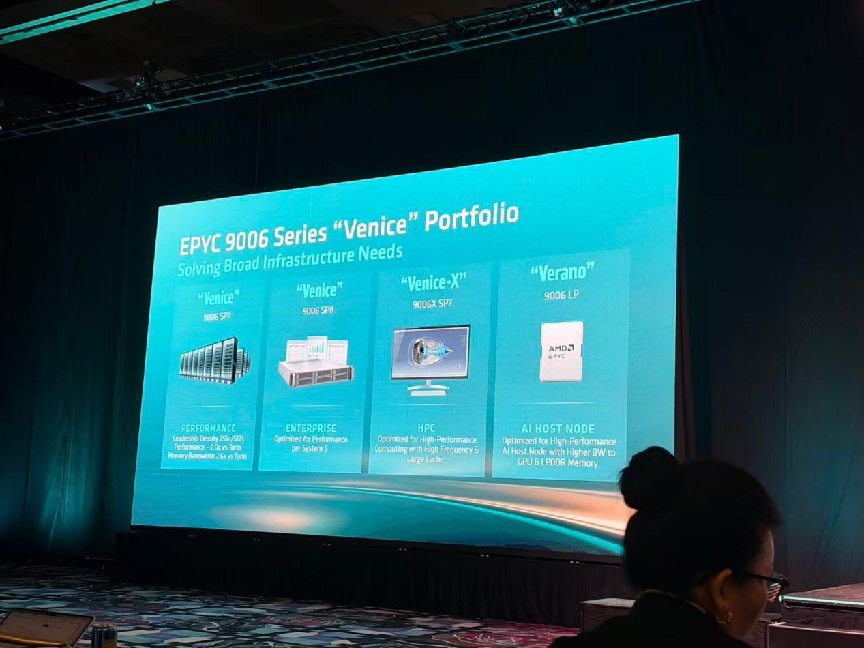
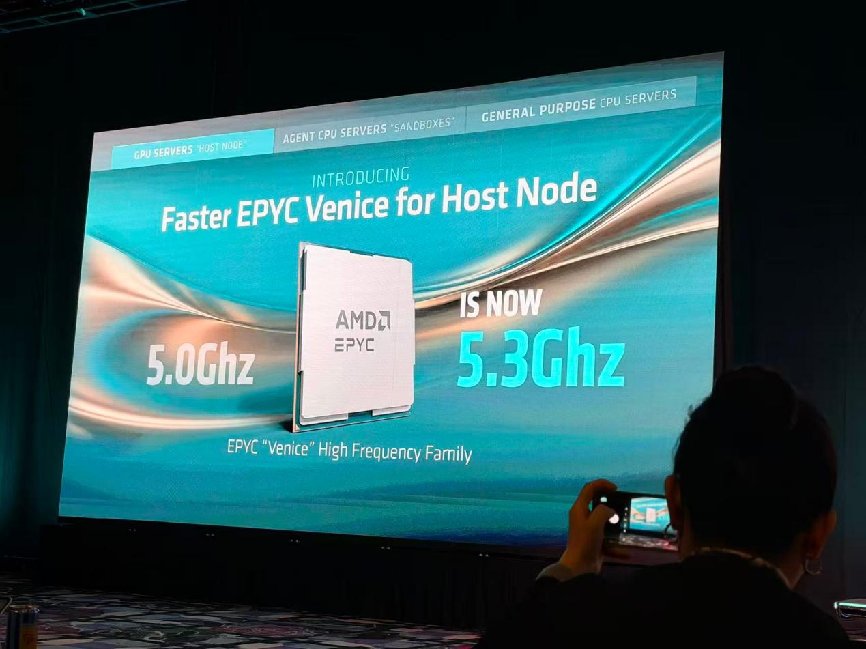
EPYC 9006 SP7(现已出货):面向AI优先的数据中心,最高256核/512线程的Zen 6c 密度核心负责Agent编排与沙箱执行,96核/5.0GHz的Zen 6高性能核心支持GPU“主机节点”。
EPYC 9006 SP8:企业通用版主打性价比市场,8核到128核的灵活配置、8通道内存、128条PCIe Gen6通道,覆盖绝大多数企业级工作负载。
EPYC 9006X SP7:配备1152MB 3D V-Cache与最高5.15GHz主频,面向科学计算、工程仿真与AI预处理等缓存敏感型场景。
EPYC 9006 LP 低功耗版(代号 Verano)则是为AI机架打造的主机节点CPU,采用LPDDR5X内存与增强型xGMI互联,以能效优先的设计专门服务GPU集群调度。
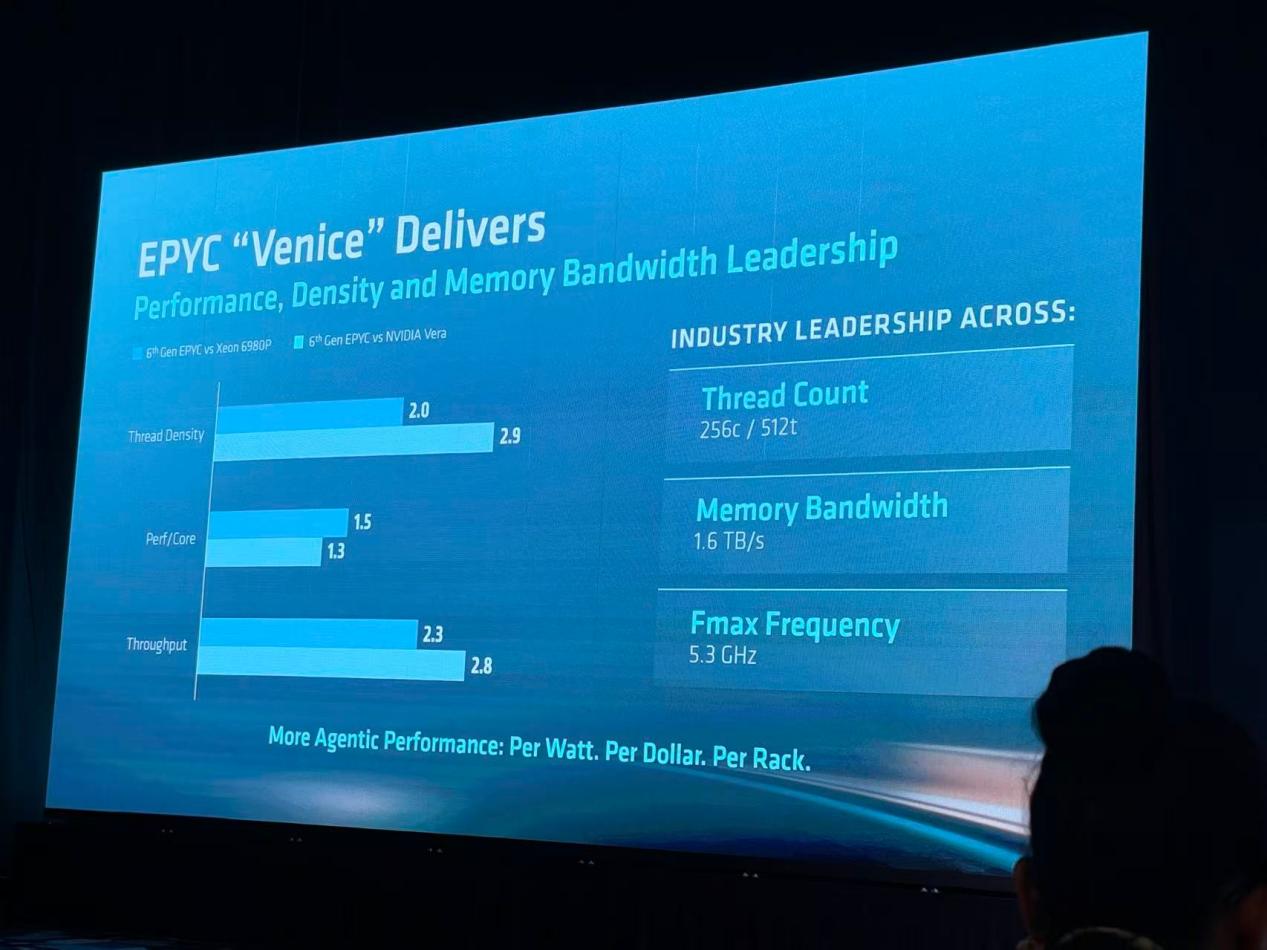
按AMD公布的数据,第六代EPYC的SPECrate总吞吐量约为NVIDIA Vera(88核)的2.8倍、单核性能约1.3倍;
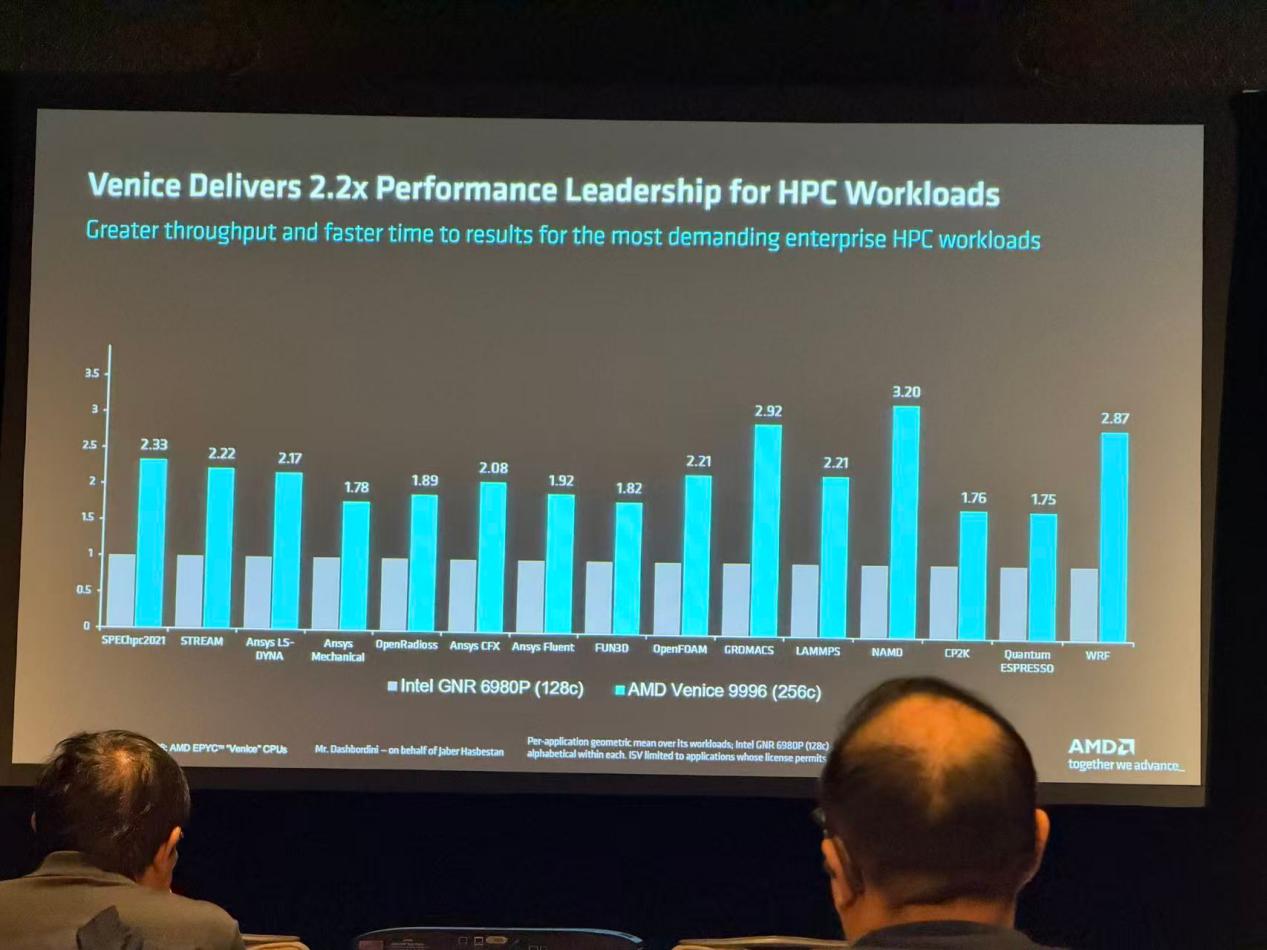
其中,AMD Venice 9996对比Intel Xeon 6980P,云原生、存储与数据库等负载最高3.3倍,HPC负载最高约2.2倍。
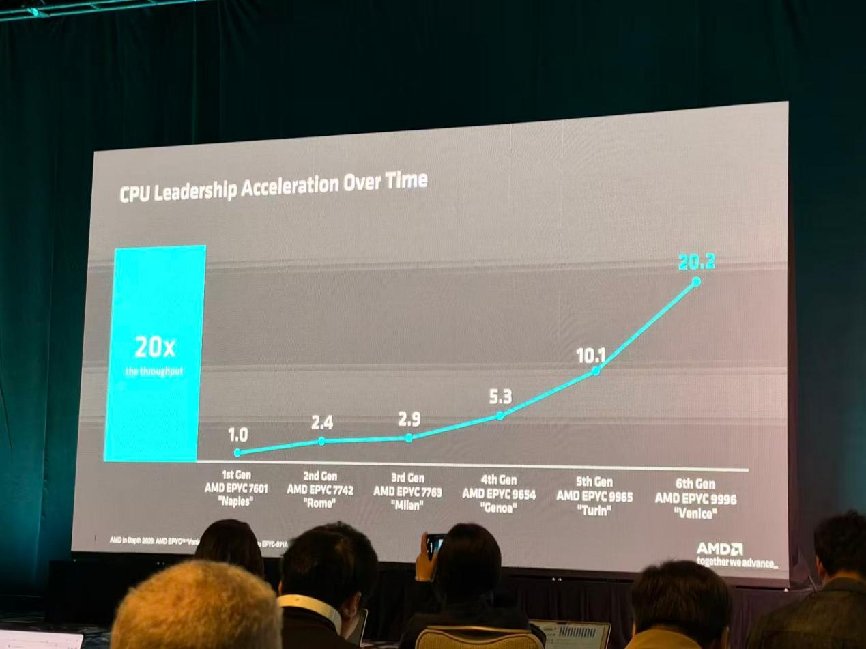
自2017年首代EPYC问世以来,AMD服务器CPU的SPECrate吞吐量已迭代近20倍,展现出在服务器CPU领域持续的创新节奏与执行力。依托Zen 6架构打造多规格、全场景CPU产品矩阵,第六代霄龙正在成为数据中心CPU市场最具竞争力的新选项之一。
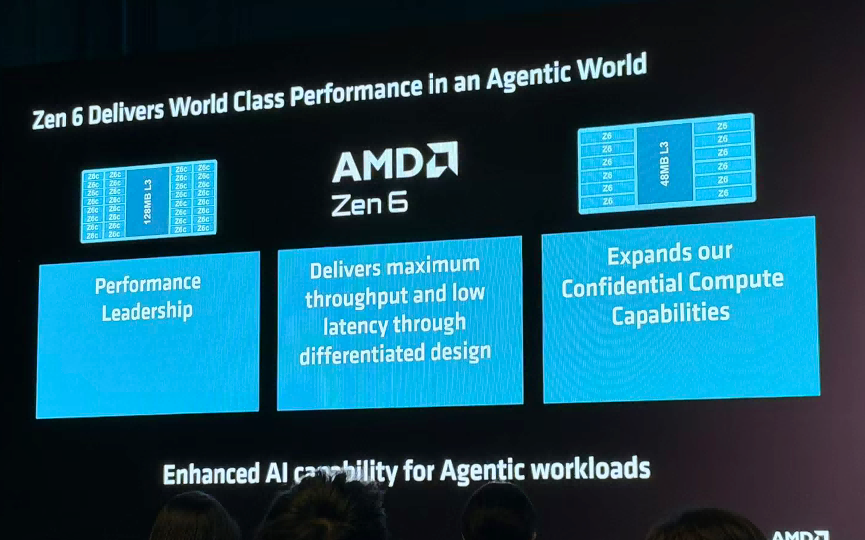
落地垂直行业:一颗为AI时代重构的服务器CPU
得益于架构与制程上的飞跃,以及众多创新技术的加持,Venice被AMD定位为各行业数据中心现代化与企业AI化的底座。“更高密度、更高能效、更低TCO”被直接转化为行业可量化的收益,并伴随EPYC 9006 SP7的出货,正在多个垂直行业兑现。
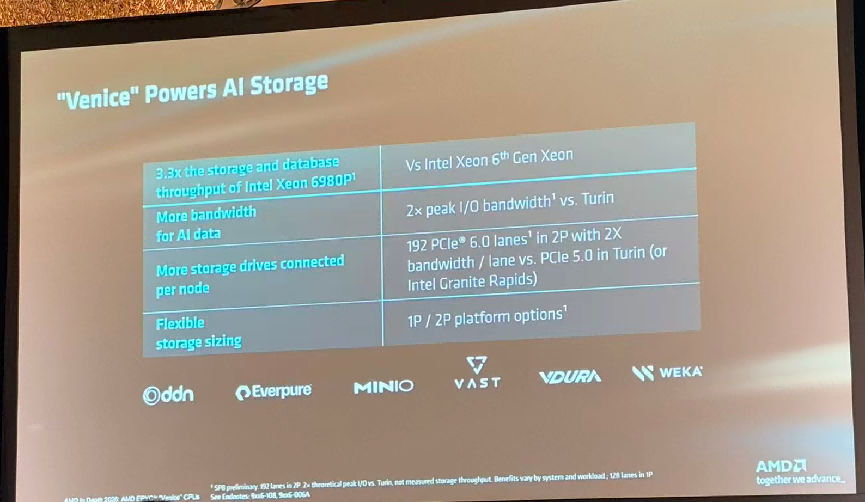
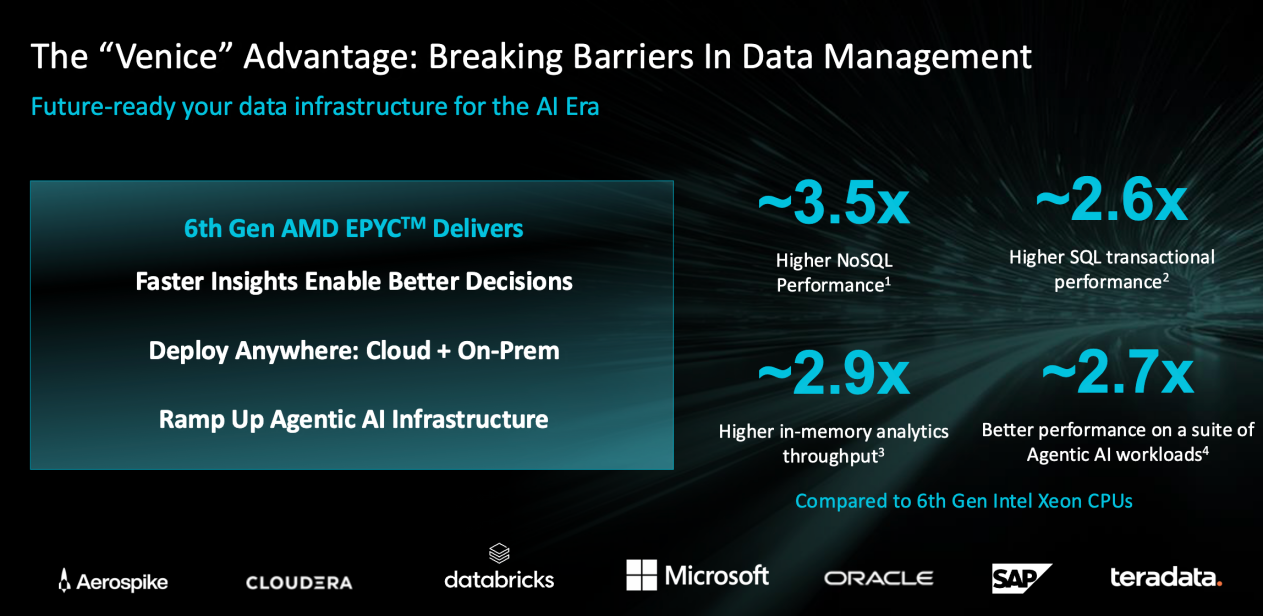
在存储与数据库领域,Venice双路吞吐达到竞品的3.3倍,SQL事务约2.6倍、NoSQL约3.5倍、内存分析约2.9倍。
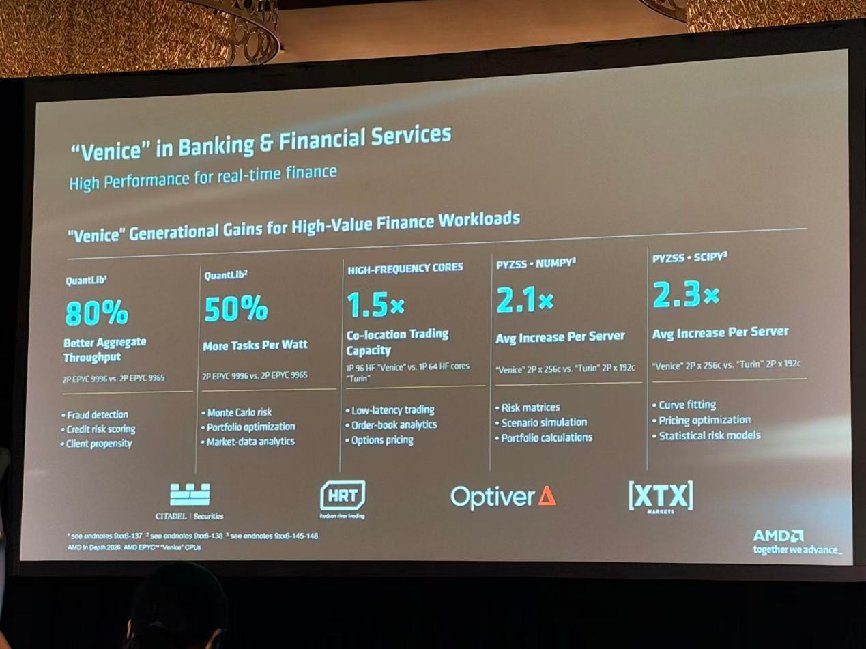
在金融服务领域,QuantLib综合吞吐提升80%、每瓦任务数提升50%,高频核托管交易容量达上一代1.5倍,NumPy/SciPy每服务器均值分别达2.1倍和2.3倍。
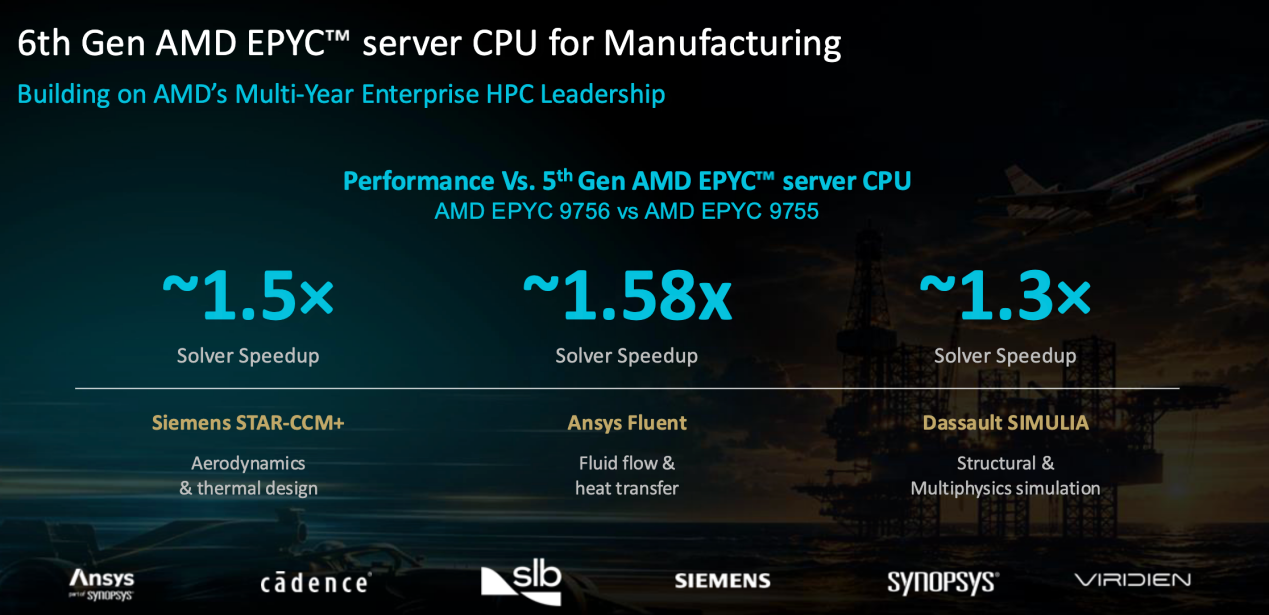
在制造与工程仿真领域,对比第五代EPYC,Siemens STAR-CCM+提速约1.5倍、Ansys Fluent约1.58倍、Dassault SIMULIA约1.3倍。
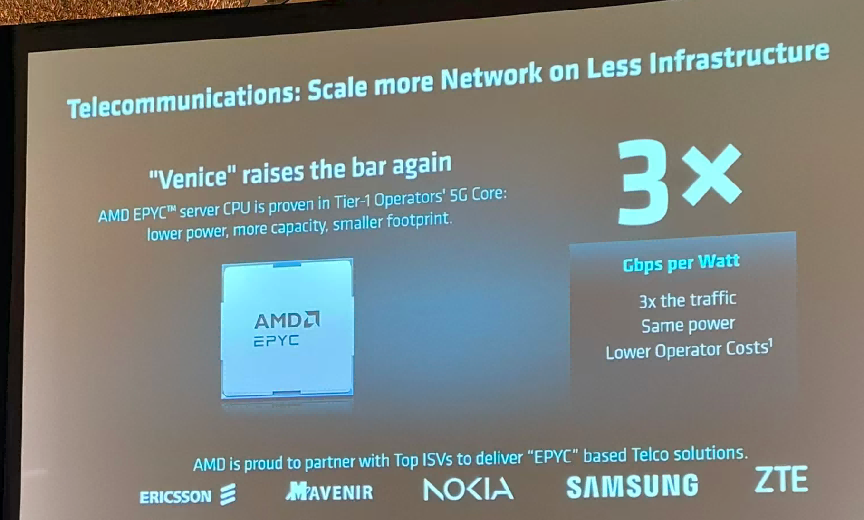
在电信行业,每瓦Gbps提升3倍,让运营商在同等电力下承载3倍流量。
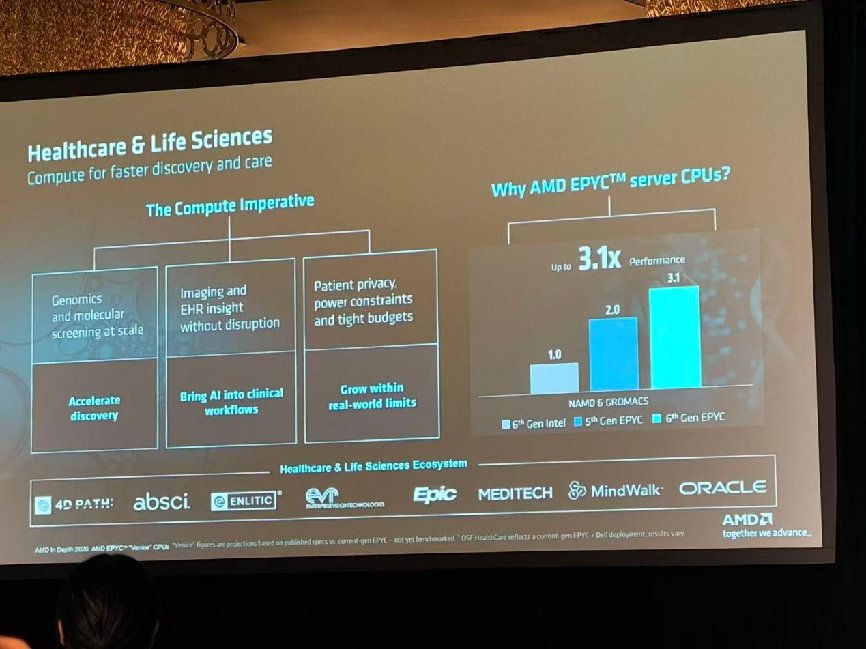
在医疗与生命科学领域,NAMD/GROMACS分子动力学性能最高约为第六代Xeon的3.1倍(基于公开规格的预测值),可加速基因组筛选与药物发现。
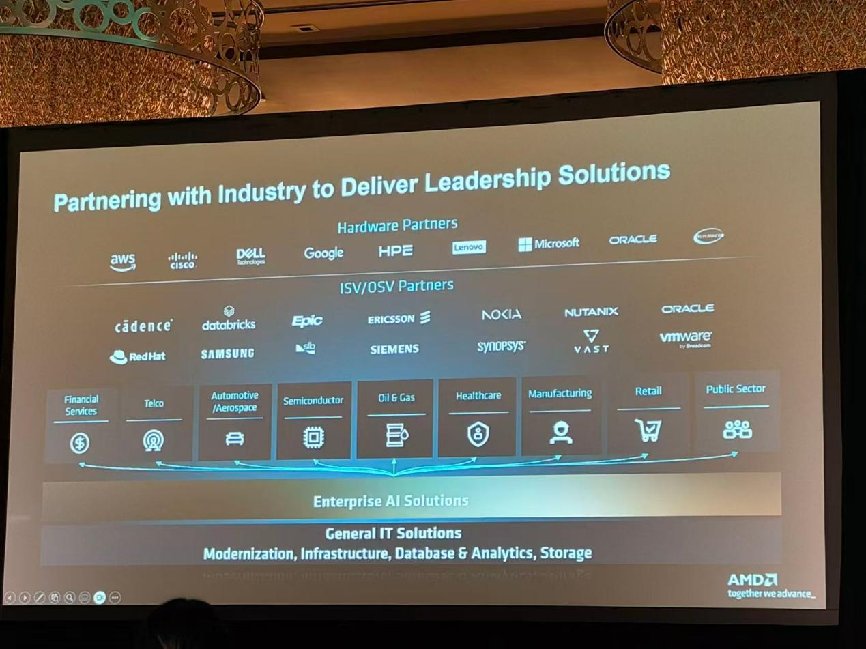
客户与生态的背书构成了Venice落地的另一翼。此次大会上,Nutanix、Red Hat、VMware(博通)均站台背书,称第六代EPYC提升了每台服务器可承载的虚拟机、容器与AI负载密度;VAST Data宣布将把Venice用于下一代CBox/EBox平台,Databricks与Synopsys也公开肯定了其工程与AI负载价值。从金融、电信、汽车航空、半导体、医疗到制造与公共部门,Venice正把“通用数据中心CPU”的传统叙事,改写为面向智能体AI时代的行业解决方案入口。
成本之战 MEXT重新定义“内存”
在存储大周期的背景之下,AMD在今年6月收购的内存初创公司Next受到广泛关注。在整合Next的创新成果之后,AMD打造出MEXT软件方案,并与Venice形成软硬协同的搭配,共同降低内存成本。
此次活动上,MEXT公司创始人兼CEO、现任AMD计算与企业AI业务拓展公司副总裁Gary Smerdon(Corp. VP Business Development, Compute and Enterprise Al)进行了分享。
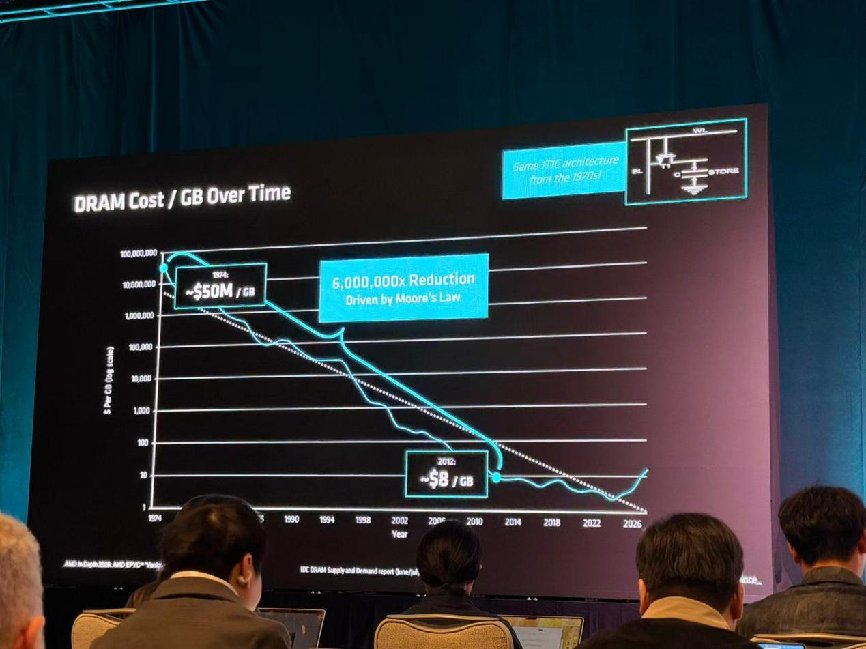
Gary的演讲从内存的发展历史切入。依靠摩尔定律,DRAM的每GB成本从1974年到2012年下降了600万倍;但在过去十余年,随着摩尔定律来到物理极限,DRAM单位GB成本下降放缓,过去一年的存储缺货涨价,反而将成本推高。
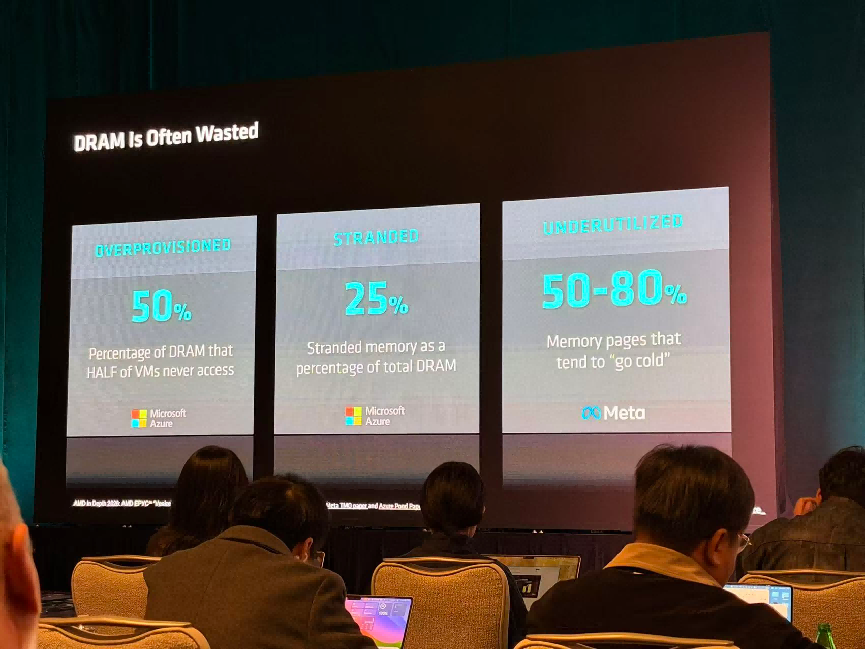
与此同时,内存被浪费的情况也普遍存在。Azure研究显示,被虚拟机占着、却从未被访问过的内存约占DRAM容量的一半;Meta的研究则表明,50%—80%的内存页在相当长时间里处于“变冷”状态。
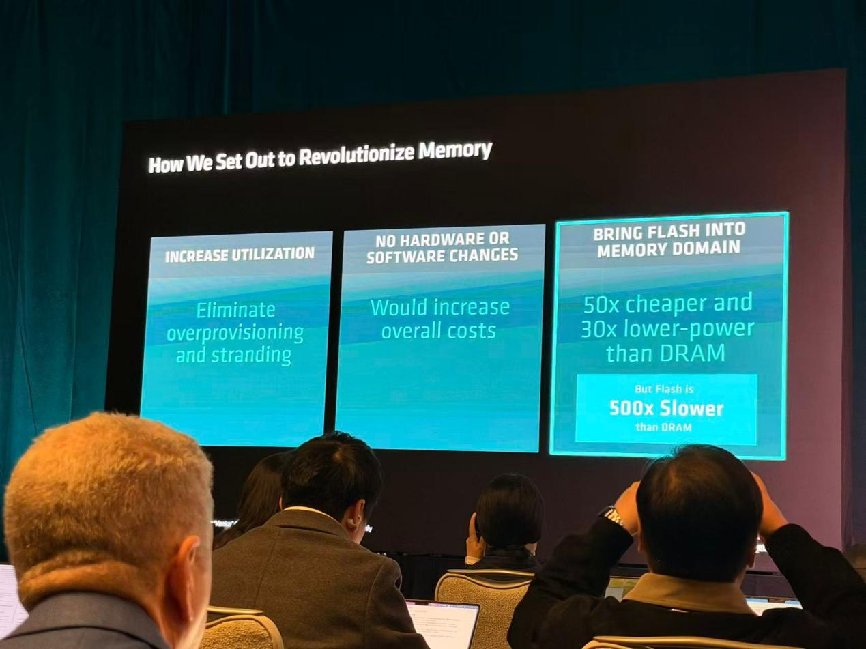
Mext的解决思路是三句话:不过度配置、不改硬件也不改软件、把便宜50倍、省电30倍的闪存引入内存层。尽管相对于DRAM,闪存要慢500倍,但Mext的核心手段是“通过AI把延迟抵消”。
简要而言,MEXT 由一组 AI 模型(含基于 transformer 的大模型)驱动:它像 LLM 预测下一个词一样,预测下一个要访问的内存页,把冷页透明卸载到闪存、再提前预判并搬回 DRAM,对上层呈现为一片连续内存。整套 AI 在本地实时训练与推理,1 秒内完成训练,仅用一颗 EPYC 核心、无需 GPU,以此抵消闪存相较DRAM的延迟差距。
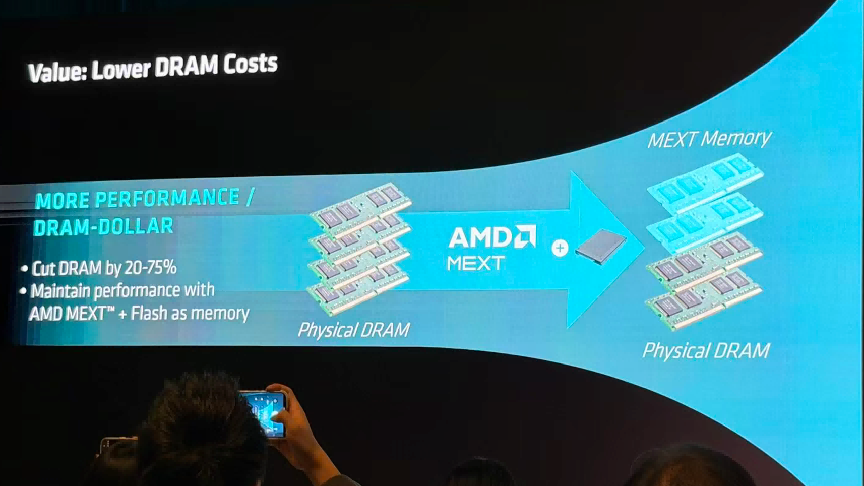
通过这项技术,在保持性能的前提下可以减少20%—75%的DRAM使用;同时借助MEXT加闪存,能把可用内存最大扩展3倍。
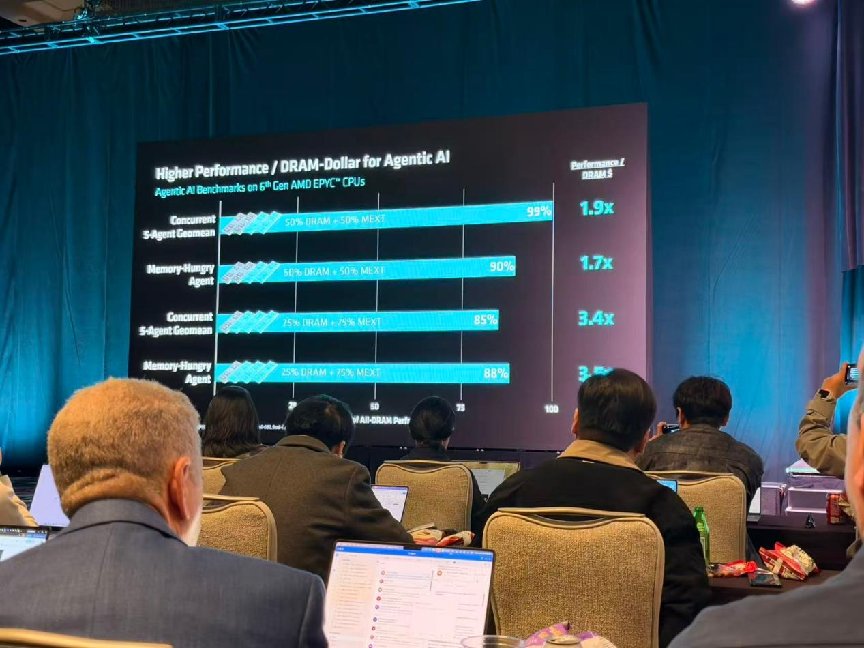
落地效果已在多个负载验证:智能体AI场景减少一半DRAM仍保持约99%性能(最吃内存的智能体为90%),每DRAM美元性能提升约1.9倍;
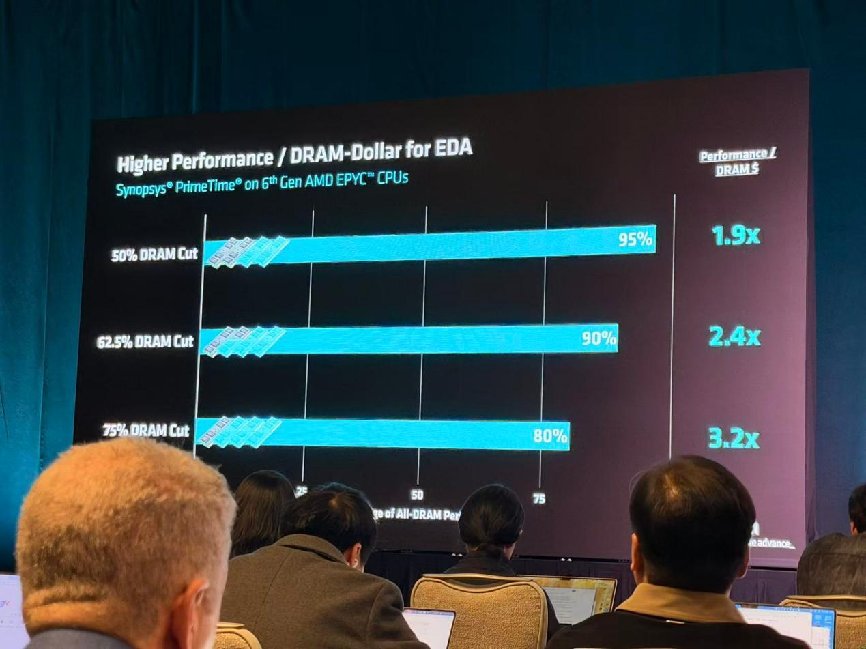
在EDA仿真场景,Synopsys PrimeTime减少50%DRAM仍维持95%性能;
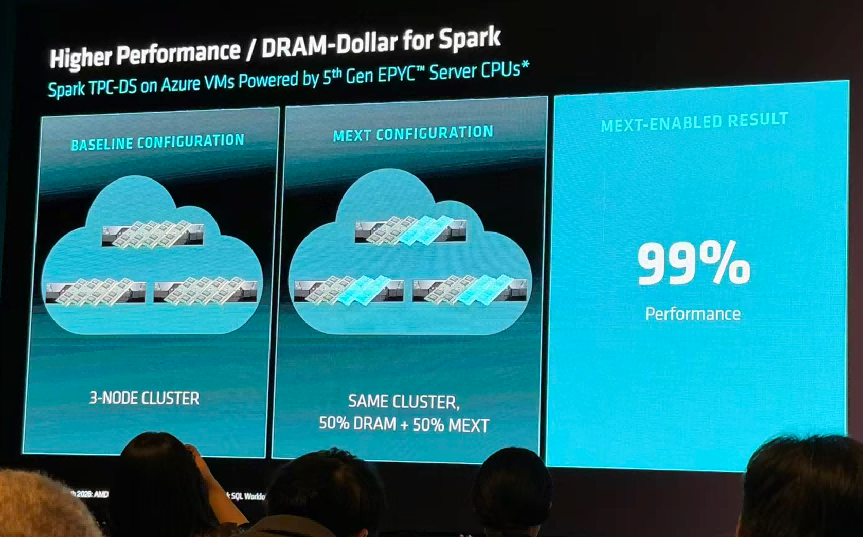
Azure上三节点Spark集群减半DRAM,性能仍维持99%(基于第五代EPYC的Azure实例)。
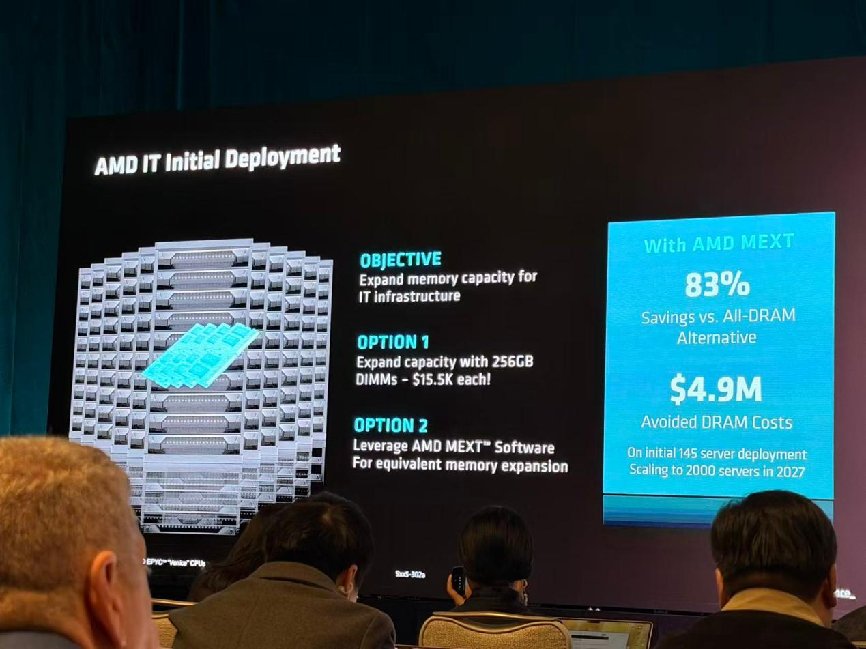
AMD自己就是“零号”客户,通过在最初的145台服务器上部署MEXT,已节省近500万美元DRAM开支,单系统成本降低83%。在DRAM成本高企的当下,MEXT将助力Venice把“每美元性能”推向新的高度。
从 Helios 到 Helion:AMD 的开放机架打法
未来AI基础设施的竞争,芯片能力只是其中一个环节,最终比拼的,是能否把多样化算力变成客户可以灵活组合、随手可用的方案。
AMD秉持开放生态理念,通过在机架等AI基础设施领域提供多样产品组合,满足不同市场需求,为客户带来更多选择、降低部署门槛。
一个月前的2026 OCP全球峰会期间,AMD发布了面向智能体AI的机架级解决方案Helion。这是继今年7月Advancing AI推出Helios机架级系统之后,AMD在机架领域的再度落子。
至此,AMD在机架层面形成三种产品组合。
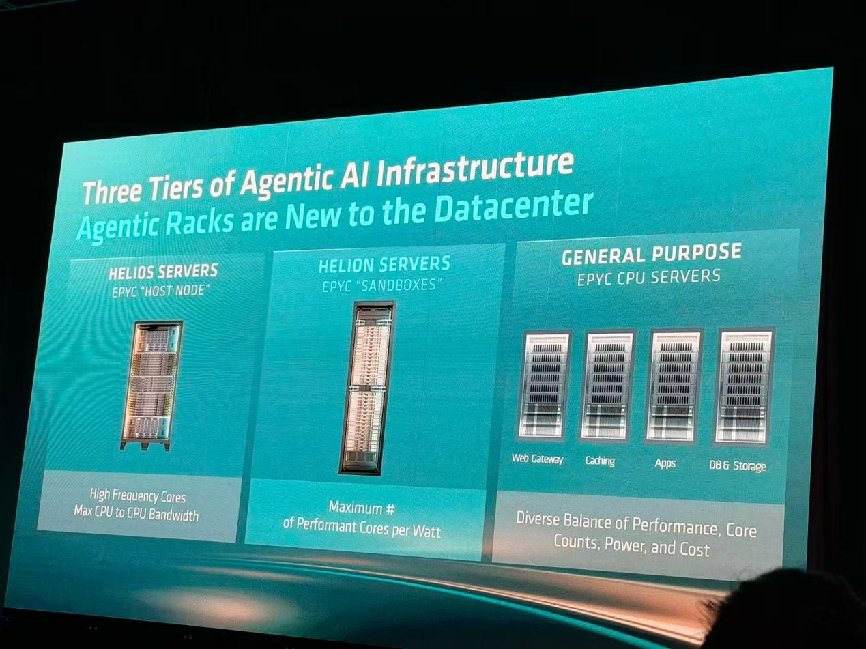
一是Helios,解决前沿模型训练与规模化推理,定位GPU“宿主节点”,特征在于高频核和最大化的CPU到GPU带宽。
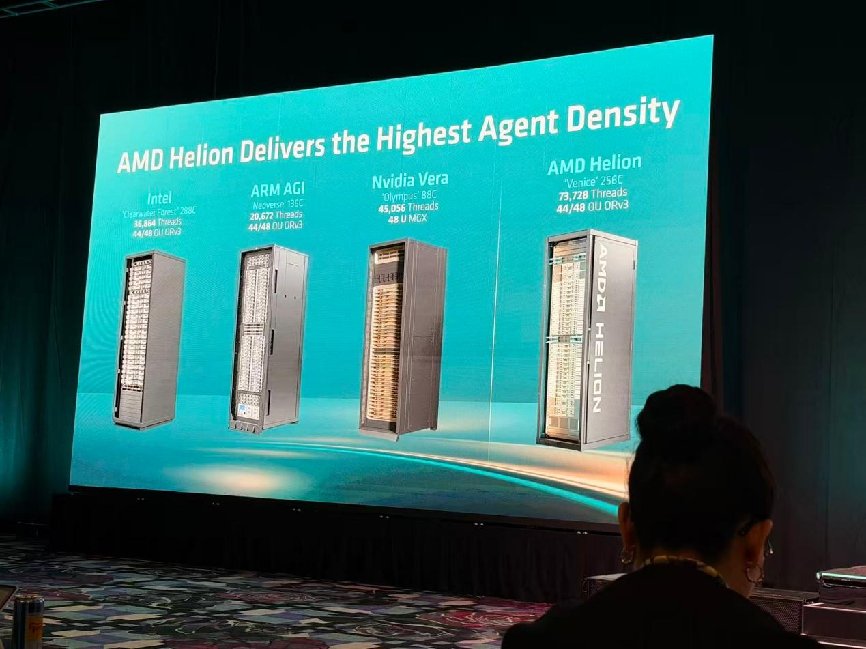
二是Helion,针对智能体沙箱,主打“每瓦最多的性能核”。在与竞争对手的整架对比中,AMD Helion提供了最高的智能体密度——用Venice 256核配置,单架达73728个硬件线程,是Intel Clearwater Forest(36864线程)的2倍、NVIDIA Vera Olympus(45056线程)的1.6倍。这意味着同样的电力和占地,Helion能同时跑的智能体数量最多。
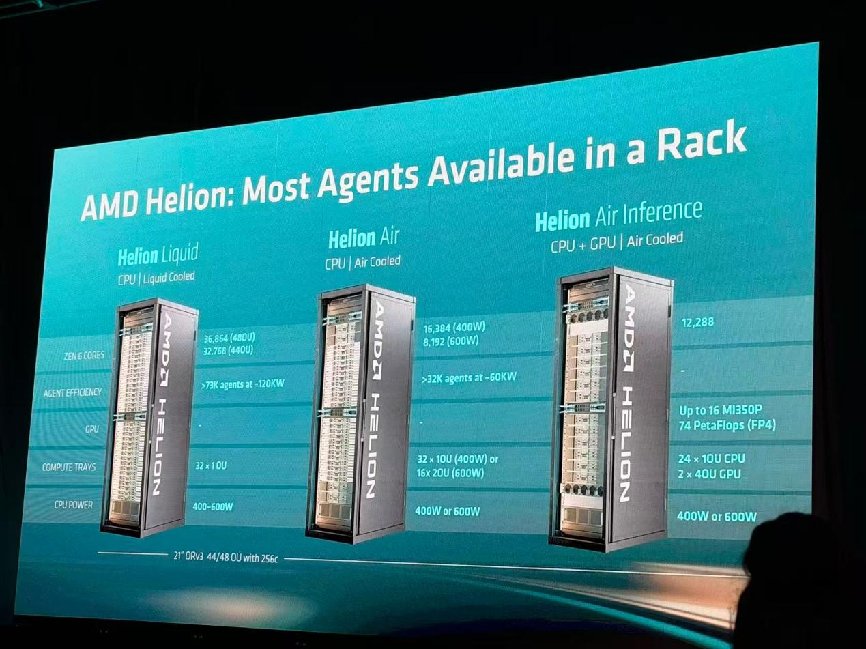
按不同散热方式,Helion分为三款:Helion Liquid液冷、120kW、单架最高36864核,密度最高;Helion Air风冷、约60kW、16384核,可跑超过3.2万个智能体;Helion Air Inference风冷混插GPU、12288核,最高可配16块MI350P。
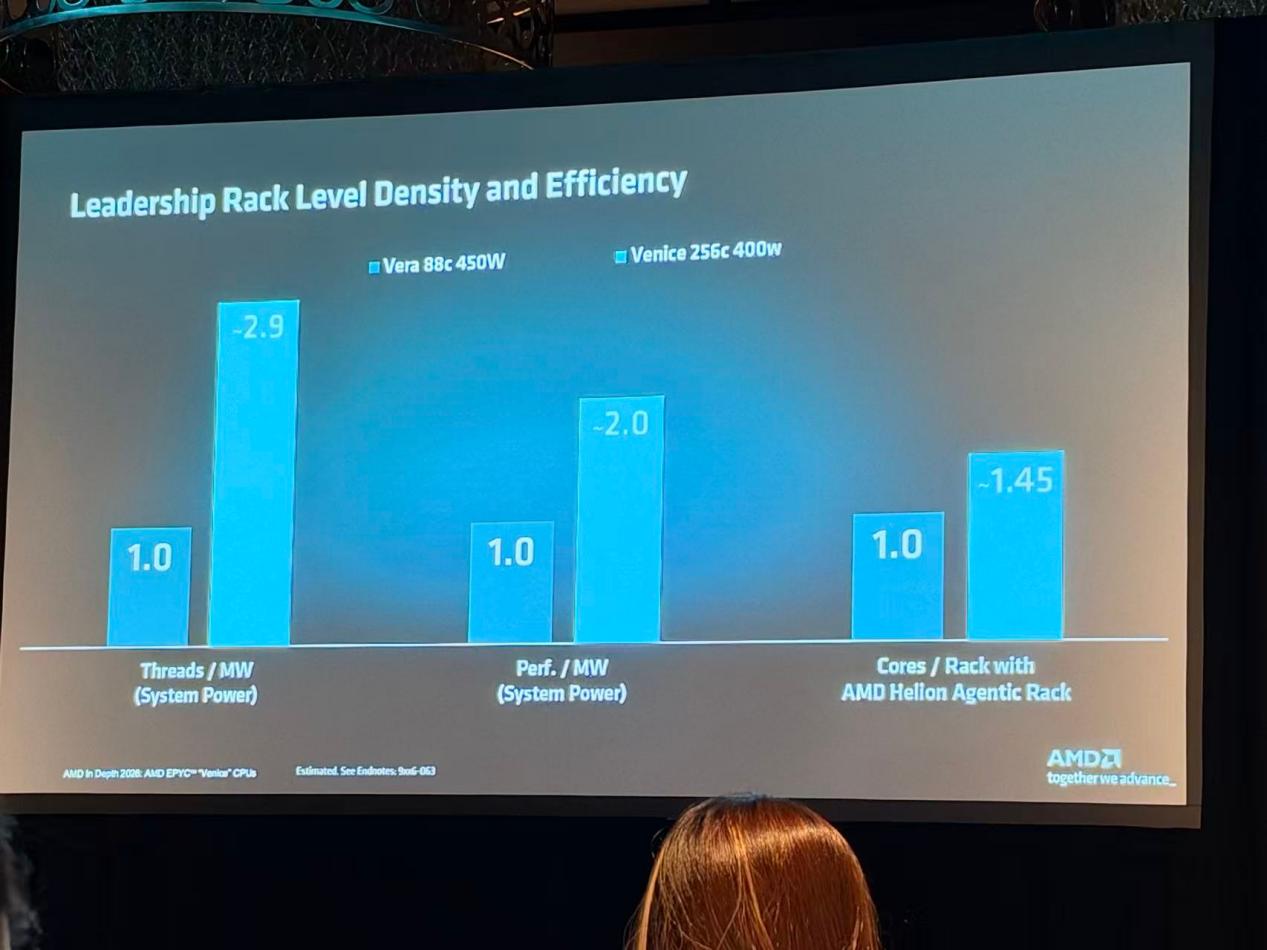
AMD表示,用Venice 256核/400W配Helion,对比NVIDIA Vera 88核/450W,每兆瓦线程数约2.9倍、每兆瓦性能约2.0倍、每机架核数约1.45倍;叠加UPP统一供电后,每插座智能体数量再提20%。
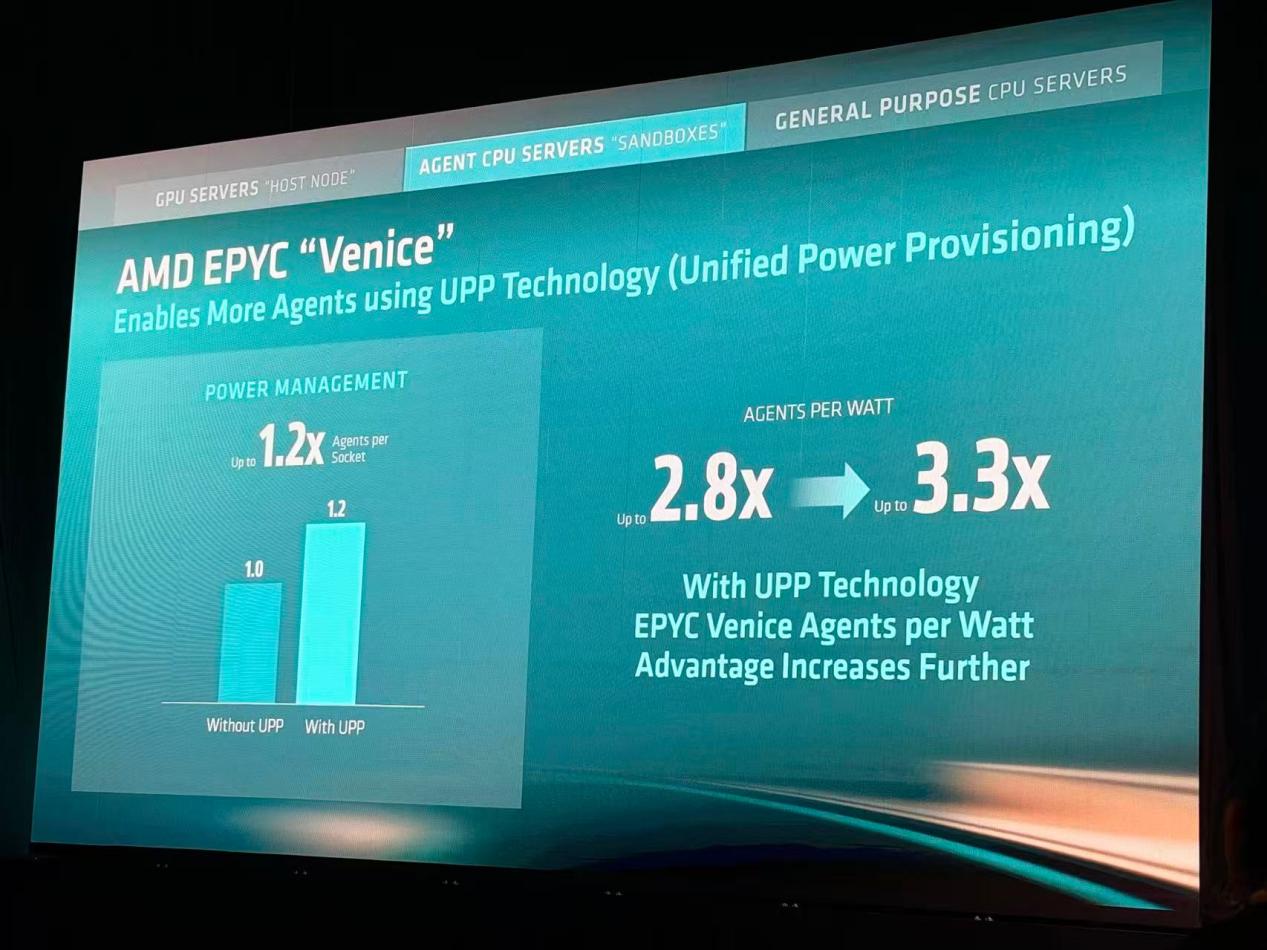
三是通用型EPYC CPU服务器,承载Web Gateway、缓存、应用和数据库存储,卖点是性能、核数、功耗、成本的多元平衡。
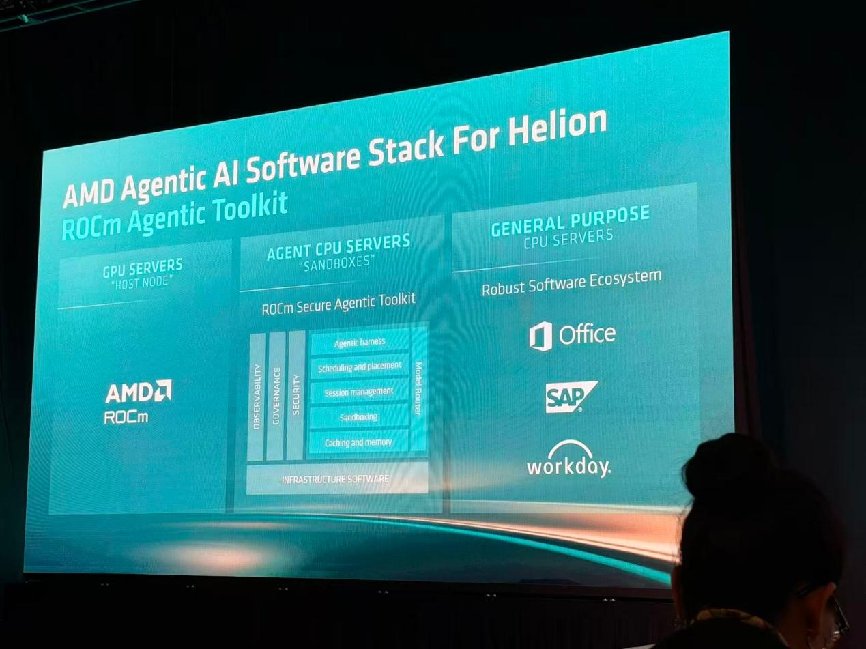
软件层面,AMD针对Helion推出ROCm Agentic Toolkit:控制面管理会话连续性与拓扑放置,执行面支持Docker、gVisor、Kata、Firecracker等多种沙箱,模型路由器再按策略、语义、容量三个维度,把请求分发到本地小模型、本地LLM或云端点。
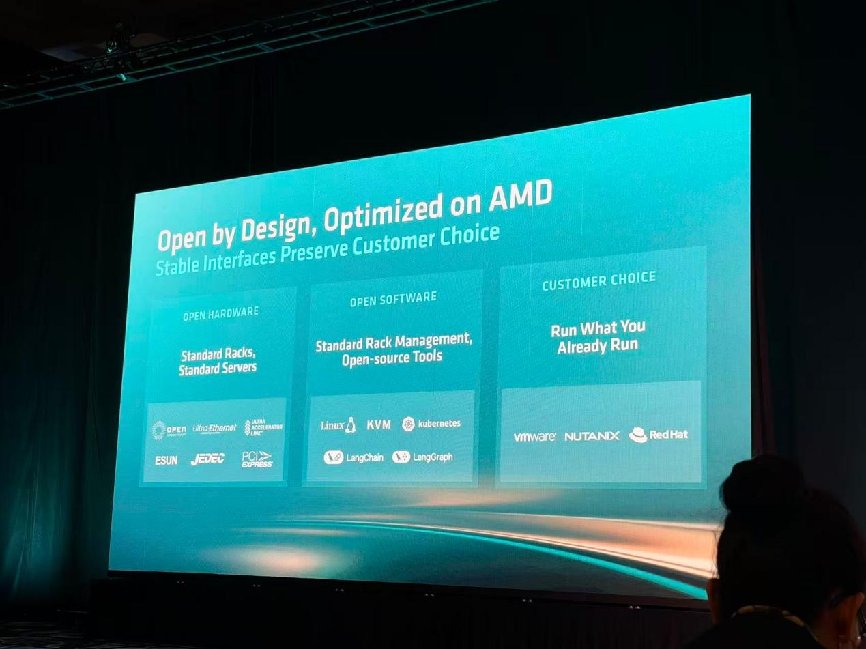
AMD 在机架战略上的核心主张是“Open by design, optimized on AMD”。Helios与Helion 全部基于OCP ORv3标准机架和标准服务器,配套标准机架管理工具与开源软件,客户今天在跑什么业务软件,将来还能继续跑,不需要绑定一家厂商。
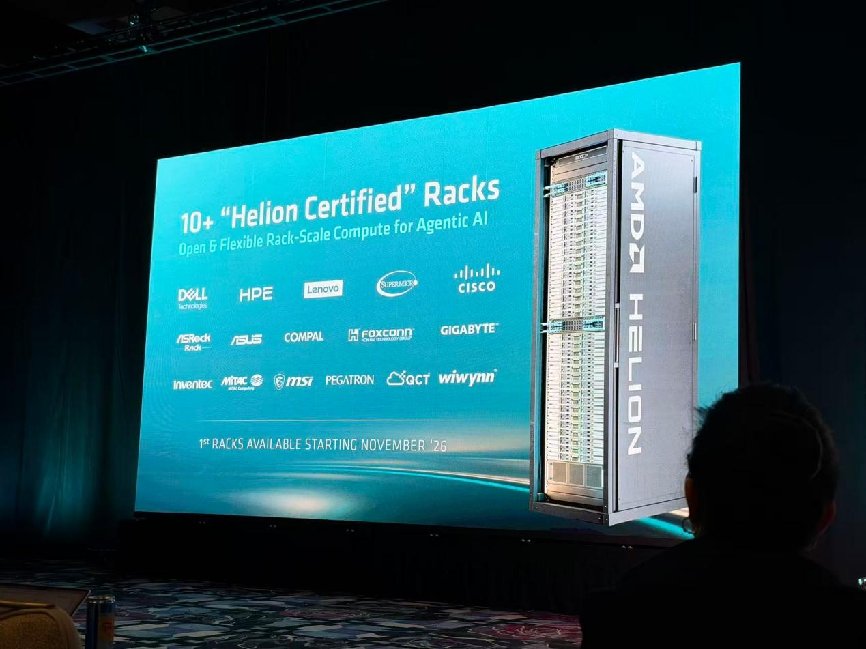
目前已有超过10个“Helion认证”机架,戴尔、HPE、联想、Supermicro、Cisco均在出方案,首批于11月起出货。
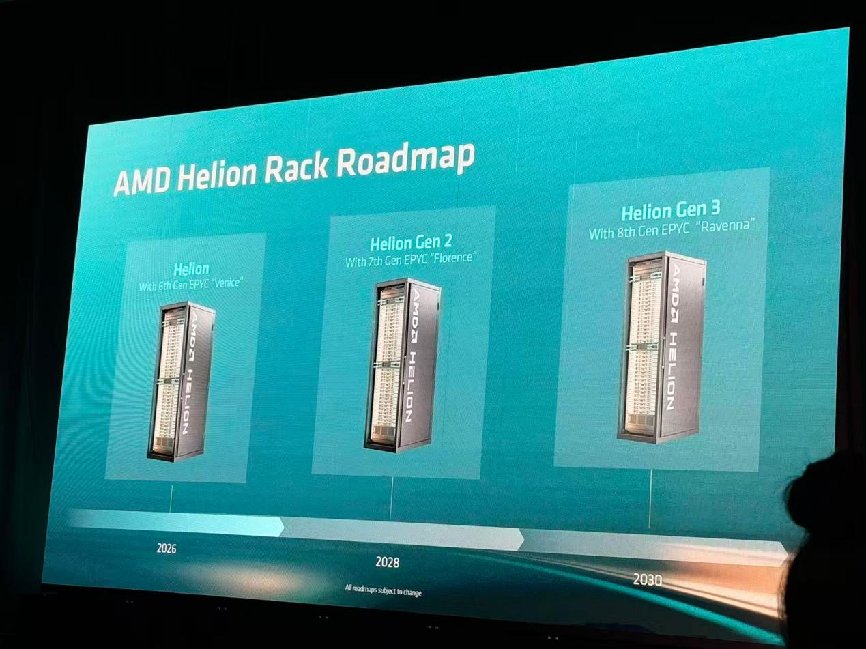
按照AMD的路线图,2028年将推出基于第七代EPYC(代号Florence)的Helion2代,2030年推出基于第八代EPYC(代号Ravenna)的Helion3代。
结语
把这三张王牌放在一起看,AMD在In Depth 2026上交出的,其实是一份对“后GPU时代”的系统回答。当行业习惯了用GPU的数量和HBM的容量来衡量AI基建时,AMD提醒所有人:智能体不是一块更大的GPU卡,而是一套需要CPU、GPU、内存、机架和软件协同重构的新计算范式。
更值得注意的,是AMD这次展现出的“全栈但不封闭”的判断力 --- 用最广的CPU组合、最开放的机架规范和最灵活的内存方案,把选择权交还给客户。
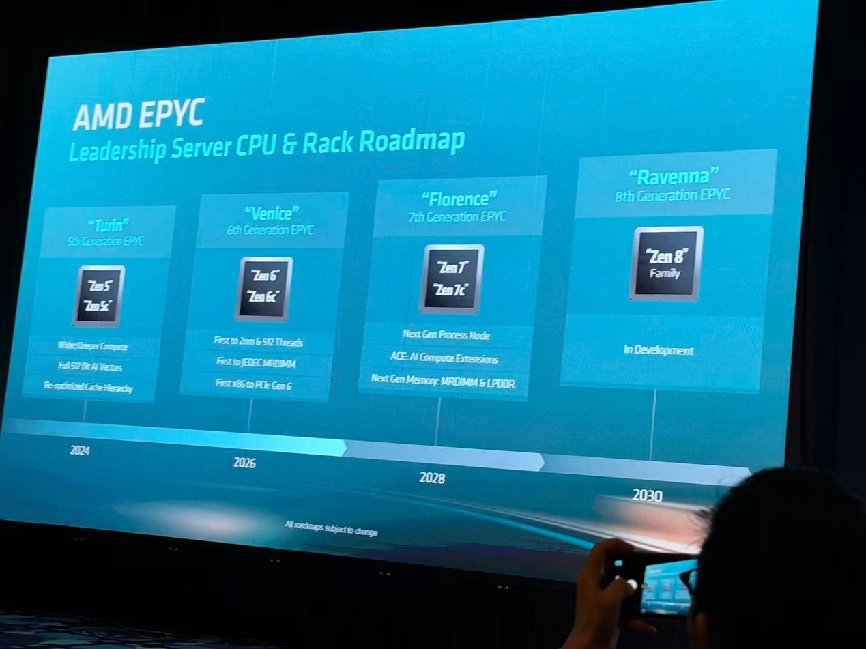
从Venice、到Helios、再到Helion,从SP7出货到2027年的SP8、Venice-X、Verano,再到2028年的Florence与2030年的Ravenna,AMD正在用可预测的节奏,把智能体时代的CPU做成一条可以和GPU主线并行的第二曲线。EPYC 9006系列的登场,不在于这一代Venice赢了多少个跑分,而在于它如何为AI基础设施立下一个更开放、更经济、也更可持续的新坐标。