以Transformer为底座、经海量语料预训练与对齐获得通用语言能力——LLM大语言模型已成为人工智能产业链的“操作系统级”资产:向下调度算力、数据与框架资源,向上承载智能体、搜索、办公与编程等全部应用。本轮AI周期的本质,是模型能力沿“预训练—后训练对齐—推理增强—智能体执行”的路径持续外溢,把语言理解转化为可直接消费的Token产出与任务交付。
模型层支出进入高增通道:据Gartner测算,2026年全球AI模型与平台支出将达640亿美元、较2025年的390亿美元增长63.4%,其中生成式AI模型投资增长117%。中国市场以MaaS(模型即服务)为主要形态:据IDC,2026年上半年中国MaaS市场规模达106.3亿元、同比增长889.4%,全年Token消耗量预计达约40000万亿次,2024至2030年复合增速高达1154.9%。
近日,集微咨询(JW Insights)发布《AI产业系列报告之LLM大语言模型(2026)》(以下简称《报告》)。《报告》以“模型即操作系统”的定位开篇,循“市场—技术—格局—展望”四步推进:先校准全球模型层支出与中国MaaS市场的增长斜率,再拆解推理增强、MoE、多模态与智能体四大技术方向,进而横向比对闭源三巨头与国产开源阵营的迭代节奏,最后落到Token经济的货币化路径与国产化三层次跃升时间表。
以下是《报告》内容精选:
市场扩容:模型支出增长63.4%,中国MaaS十倍跃升
全球模型层进入放量期:智能体与多模态应用推动模型消费从“按次问答”走向“按任务交付”,模型层在AI总支出中的占比趋势性上升,生成式AI模型投资增速达117%、显著快于平台层。用户基础同步扩大:ChatGPT周活跃用户超12亿,我国生成式人工智能用户规模达6.02亿人、普及率超过四成,全球模型消费进入规模化阶段。
中国市场的爆发更具弹性:2026年上半年MaaS市场规模106.3亿元、同比接近十倍增长,占公有云PaaS市场的比重较2025年下半年提升逾15个百分点;IDC预测2026年全年Token消耗量约40000万亿次、营收约186亿元。合规体系同步铺开——累计已有988款生成式AI服务完成备案、598款应用完成登记,为模型商用提供确定性规则。
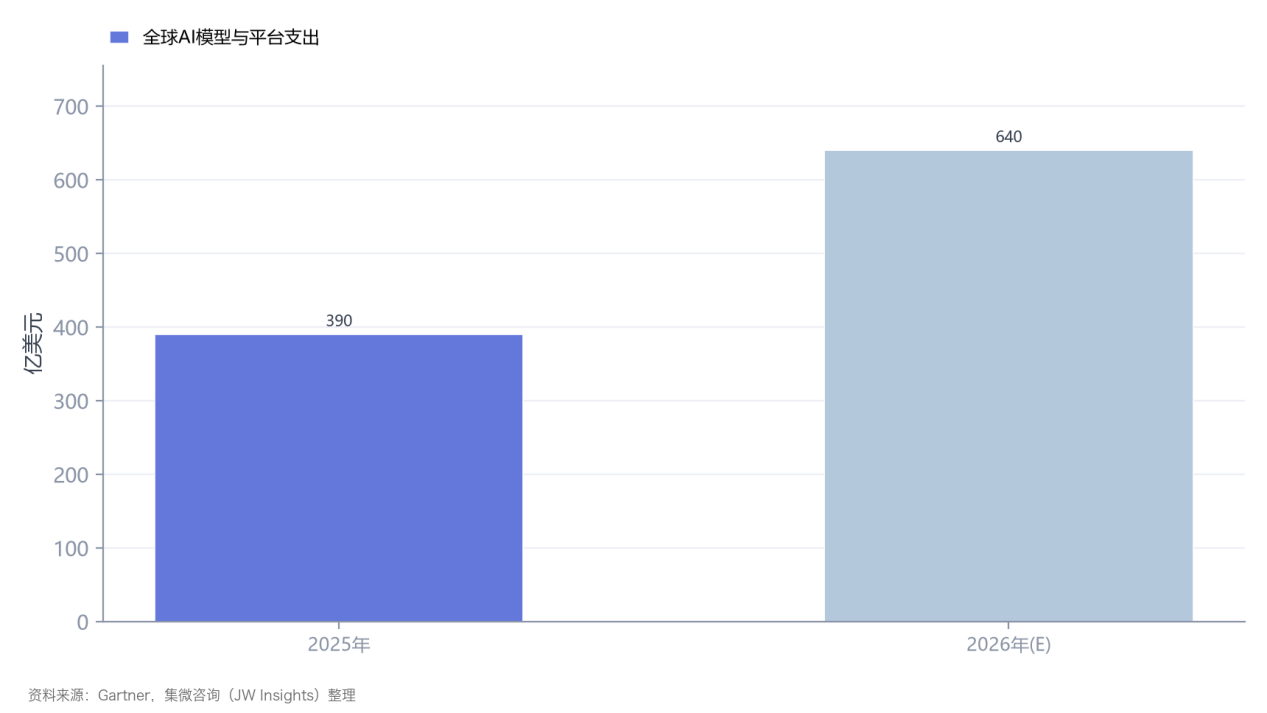
图1:全球AI模型与平台支出及预测(亿美元)
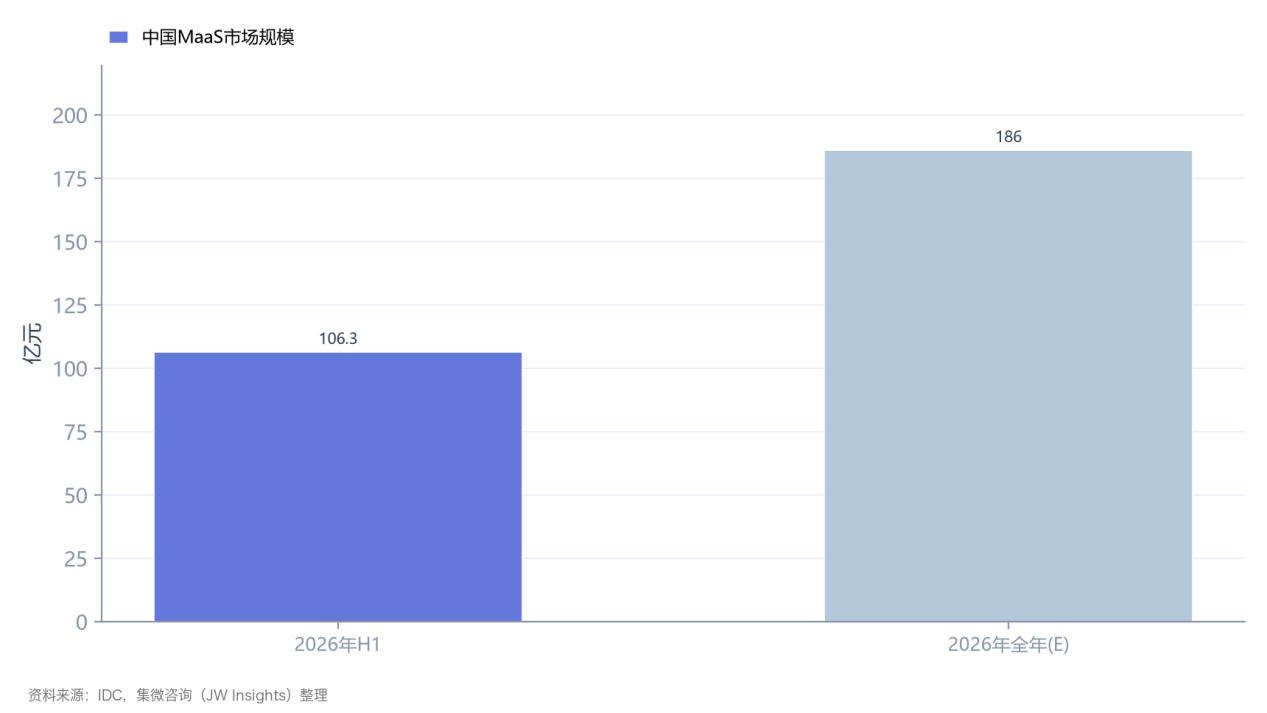
图2:中国MaaS市场规模及预测
技术主线:推理增强成标配,MoE压低单位成本
技术演进围绕“更强能力、更低单位成本、更闭环任务交付”展开。推理增强成为旗舰标配——以强化学习激励思维链,模型在数学、代码与复杂规划上大幅跃升;MoE稀疏架构全面普及——大参数量、小激活量的组合成为旗舰共同选择,国内厂商已开源千亿参数级MoE模型,架构效率直接转化为单位Token成本的下降,构成价格战的技术基础。
多模态与长上下文收敛为标配,上下文窗口扩展至百万Token量级;智能体成为模型能力的交付形态,厂商从出售API转向交付“可持续执行任务的数字员工”,评估口径从词元消耗转向任务交付质量。扩散式生成等非自回归路线在速度上展现数量级潜力,底座路线尚未收敛。瓶颈同样清晰:安全对齐推迟发布的案例已出现,高质量数据与先进算力趋紧,行业盈利模型尚未普遍跑通。
格局透视:Anthropic反超OpenAI,开源阵营快速追赶
闭源阵营沿三条路径竞争。OpenAI以12亿周活的消费入口定义交互范式,二季度收入67亿美元,正筹备潜在估值超一万亿美元的IPO;Anthropic以企业级市场反超——二季度收入116亿美元、超过OpenAI,Claude Sonnet 5.5速度提升三成以上、价格下降三成;谷歌是唯一实现“自研算力—自研模型—全球分发”全栈闭环的厂商,Gemini 4 Carbon登顶新版智能指数,训练与推理已拆分至TPU独立芯片、每瓦性能翻倍。
国产开源阵营快速追赶:DeepSeek以纯强化学习与蒸馏技术树立开源标杆、将训练成本压缩至远低于同行并允许无限商用;阿里通义千问构建全球最大开源模型家族之一,千问App居国内AI原生应用月活第二;智谱GLM-5.2支持百万Token上下文、在全球盲测平台Code Arena位列可用模型第一;昆仑万维天工3.0采用四千亿参数MoE架构,开源的Skywork-MoE总参数146B、激活仅22B;MiniMax发布国内首个代码、超长上下文与原生多模态三项合一的通用模型。开源与闭源的能力差距持续缩小。
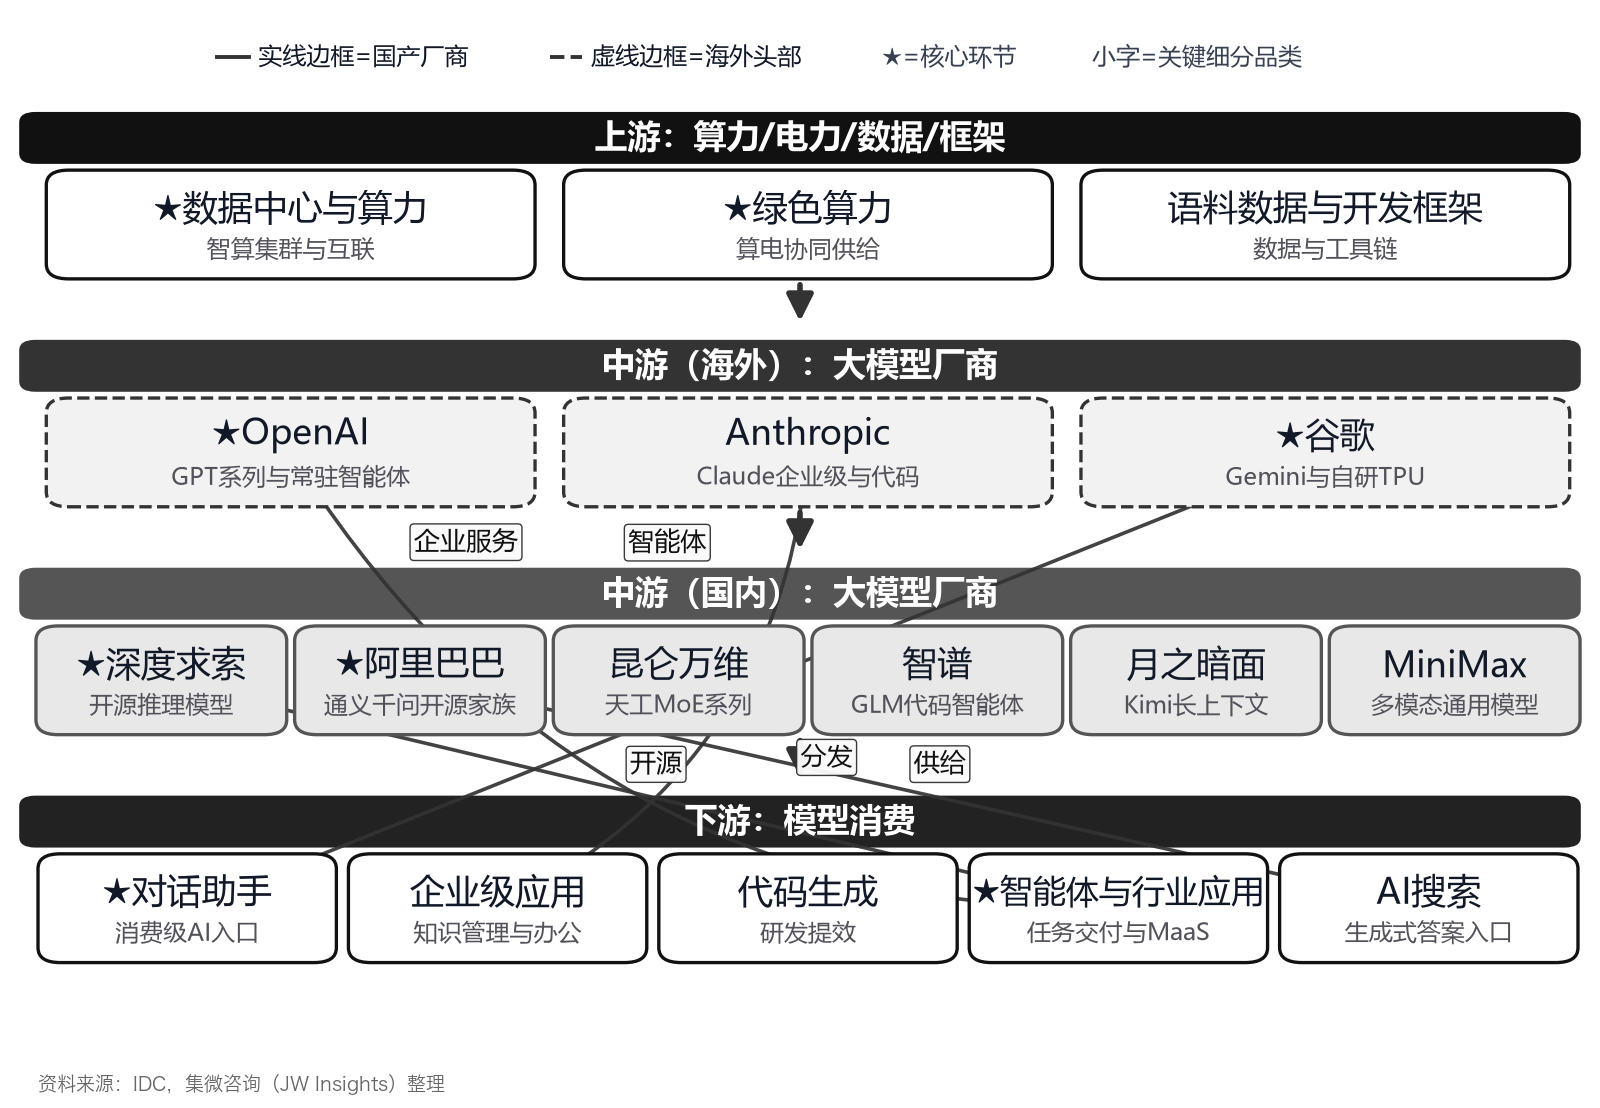
图3:LLM产业链图谱
Token经济:推理接棒训练,算电协同压降成本
增量逻辑正在切换:训练市场随头部模型代际趋稳而增速回落,推理侧随智能体、搜索与编程助手渗透持续扩张,Token经济从概念走向规模化实践。据Gartner预测,2028年将有33%的企业软件嵌入代理型AI,而2024年这一比例几乎可以忽略;企业级场景中代码、办公与行业知识库的人均Token消耗远高于对话,构成模型层收入弹性的主要来源。
成本端呈“单位成本下行、总投入上行”的并行格局:MoE与推理侧优化推动单位Token成本沿代际快速下降,头部厂商却持续加码数据中心投入。算力与电力构成成本大头——电力占数据中心运营成本超四成,2025年全国算力中心总用电量已达1700亿千瓦时,算电协同成为成本管控关键。具备入口流量、自有算力与软件生态闭环的厂商,成本消化能力显著占优。
趋势与路径:智能体落地,国产三层次跃升
《报告》研判五大趋势:推理取代训练成为模型层价值主体;模型底层从一元自回归走向多路线并存、效率成为竞争主轴;开源与闭源差距持续缩小、开源成为标准输出关键变量;智能体成为交付形态、竞争升级为“算力—模型—入口—生态”体系化竞争;治理规则与算力供给构成双重外部约束。技术节点依次展开:2026至2027年智能体规模化落地,2027至2028年训推分工与算力解耦深化,2028年以后多模态世界模型与端云协同开启。
国产化沿三层次跃升:本土模型消费市场与开源生态国产化率最高,重点从数量扩张转向价值提升;企业级与代码场景处于快速提升期,国产开源旗舰已在盲测中取得领先;底层架构原创为攻坚方向,国产厂商已在MoE效率创新上证明实力。时间表上,2026年国产模型主导本土市场、开源家族服务全球开发者;2027年智能体成为模型层主要收入载体;2028年以后,依托“用户规模+开源生态+自主算力”组合优势,国产LLM有望实现从追赶到局部引领的跨越。风险在于安全对齐与幻觉约束企业落地、数据与算力供给趋紧、以及资本开支与收入兑现的时间差。
目前,《AI产业系列报告之LLM大语言模型(2026)》已在爱集微官网与APP正式上线,欢迎登录爱集微官网或集微APP,在首页点击“集微报告”栏目,即可进行订购。