一、ZCode里悄然上线的“速度选手”:灰度实测逼近每秒500个token
10月12日,据智东西、量子位等多家科技媒体报道,智谱已在旗下AI编程工具ZCode中悄然开启高速旗舰模型GLM-5.3 HighSpeed的测试,当前版本为ZCode 3.15.1。X平台AI编程博主Leo(@leo114119)晒出的实测信息显示,他已经灰度到这款模型,输出速度超过490TPS(tokens/s,即每秒生成的token数量)。
TPS指的是每秒生成的token数量。如果持续保持这一速度,输出1万个token,单算生成阶段约需20秒。量子位随后也在ZCode中尝试手动添加并切换该模型,但因Lite套餐资格或灰度范围所限未能如愿——目前GLM-5.3 HighSpeed只对ZCode订阅用户随机开放,也没有明确的内测申请入口。
二、490TPS是什么概念:当前国内主流模型速度的数倍
大模型API评测平台AI Ping的数据显示,DeepSeek V4.1 Flash官方API的输出速度为121.34TPS,智谱官方GLM-5.3标准API的输出速度为70.84TPS。按此计算,GLM-5.3 HighSpeed的灰度实测速度约为DeepSeek V4.1 Flash官方API的4倍,约为智谱GLM-5.3标准API的近7倍。
放在智谱自身的产品线上,这一速度同样跃升明显:上个月(9月18日)刚上线的GLM-5.3-FlashX,最高输出速度也“只有”200TPS;而按照Artificial Analysis的测速,GLM-5.3-Flash在Z.ai API上的输出速度约为60TPS。放眼海外,谷歌8月13日发布的Gemini 3.7 Flash输出速度飙升至每秒340个token,是那波新模型中速度最突出的产品。
【图表:主流大模型输出速度对比图】
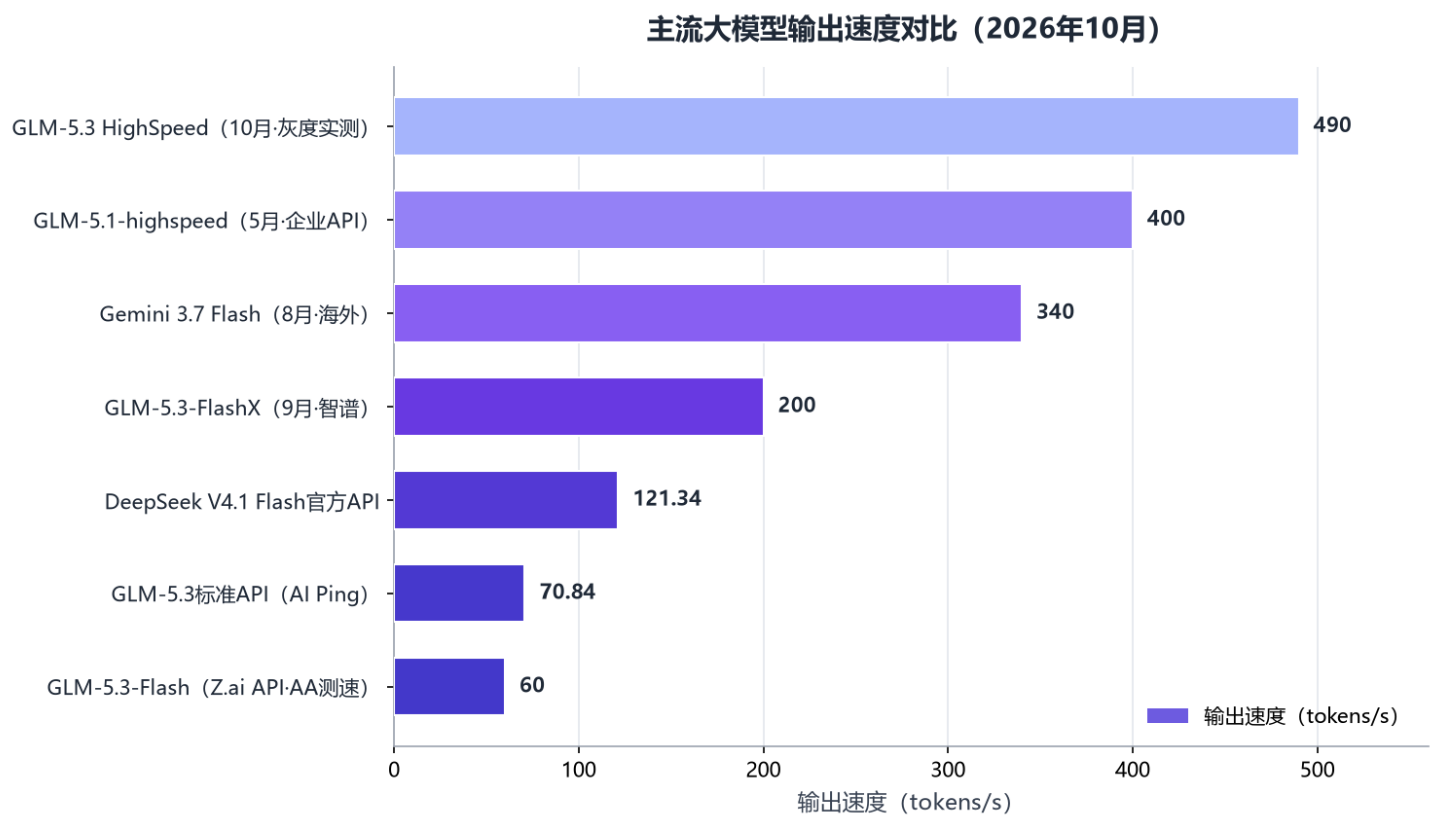
从对比看,GLM-5.3 HighSpeed的490TPS较2026年内亮相的主流模型速度实现整体跃迁:较智谱自家9月的GLM-5.3-FlashX(200TPS)翻了一倍多,较AI Ping口径下的DeepSeek V4.1 Flash官方API(121.34TPS)约为4倍,较智谱GLM-5.3标准API(70.84TPS)接近7倍。若这一速度能在规模化服务中兑现,将重新定义AI编程场景的响应基线。
三、模型规格:100万token上下文、128k最大输出,价格尚未披露
事实上,GLM-5.3 HighSpeed并非无迹可寻。早在一个月前,它就出现在开源编程智能体Pi harness的官网上,Pi的模型目录也已收录GLM-5.3-Highspeed。
目录信息显示,GLM-5.3-Highspeed上下文窗口为100万token,最大生成token上限为131072个(约128k),并划分low、high、max三档思考强度配置——这些配置与GLM-5.3普通版完全一致。目前,该模型的输入输出价格尚未披露。
社区层面,Reddit上已有网友讨论这款新模型,并猜测它是否与OpenCode 9月上新的匿名模型Omen Alpha有关——后者基本已被网友扒出与GLM相关。至于Omen Alpha到底是什么模型,众说纷纭:有人说它就是GLM-5.3-Highspeed,也有人猜是GLM-5.3-Omni、GLM-5.4-Flash。从已有实测反馈看,社区给出的总结是:速度快,思考久,效果还蛮好。
四、为什么“快”如此重要:Coding Agent时代的时间账
高速模型的价值,智谱在今年5月发布GLM-5.1高速版时就曾展示过:一个Coding Agent任务往往需要经历数十轮模型调用,单轮响应只要慢上几秒,整体耗时就可能拉长十几分钟;更快速的模型相当于给写代码“开10倍速”,模型能够一边理解工程上下文,一边持续生成代码与修改方案,用户刚输入需求,函数、接口与调用链已经同步展开。
需求侧的数据同样在印证“速度”的分量。据国家数据局数据,中国日均Token调用量从2024年初的1000亿(0.1万亿)跃升至2025年底的100万亿,2026年3月已突破140万亿,两年增长超千倍。行业研究亦指出,基础模型赛道的竞争已从单纯通用问答能力比拼,转向长上下文、智能体编程、端侧设备操作、多工具协同和智能体自主执行等真实场景生产力维度,市场评判标准从单一性能跑分升级为“模型能力+工具生态+完整工作流”的综合体系能力。
【图表:中国日均Token调用量增长图】
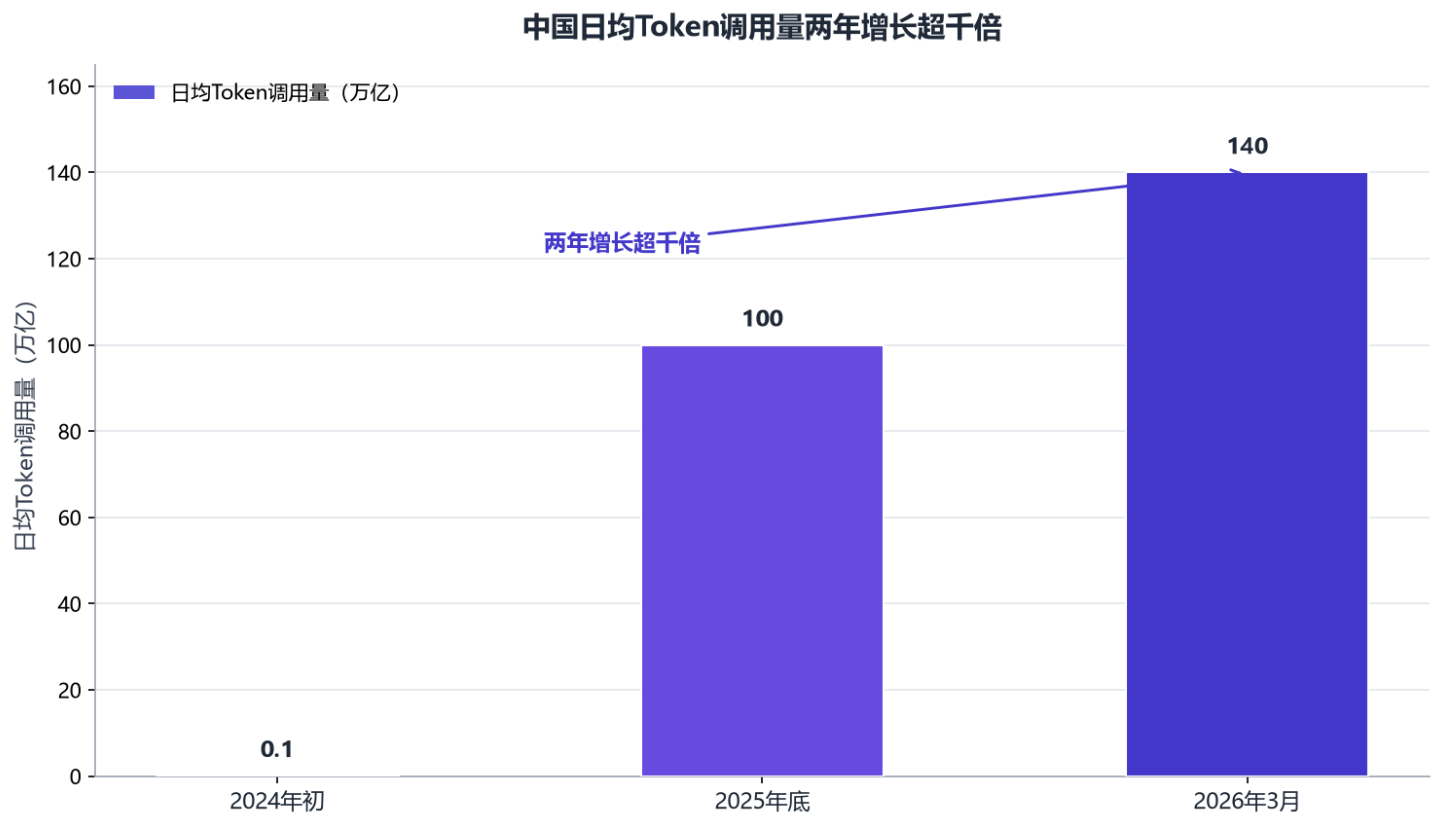
从增长曲线看,日均Token调用量两年间从0.1万亿攀升至140万亿,增长超千倍,意味着推理吞吐已成为AI基础设施的核心负荷;在Agent长程任务与大规模生产环境中,单点速度的提升会被数十轮调用持续放大,这正是智谱等厂商押注“高速模型”的产业逻辑。
五、从400TPS到490TPS:智谱的速度产品线与模型家底
这不是智谱首次推出高速旗舰模型。今年5月,智谱就曾面向部分企业用户推出高速版API“GLM-5.1-highspeed”,输出速度达到400TPS,在当时基本刷新了全球大模型厂商API的速度上限。
速度之外,智谱近几个月完成了密集的模型矩阵更新:
- GLM-5.3旗舰(8月14日发布):参数规模7530亿,与上一代基本一致,能力跃升主要来自后训练阶段的更长训练时间、更丰富任务环境与更大规模强化学习。在Terminal-Bench 3.0中,得分从GLM-5.2的4.6分跃升至28.3分;在DeepSWE v1.1中,从46.2分提升至66.9分,均位列开源模型第一;在GDPval-AA v2中得分1769,超过GLM-5.2的1508与Kimi K3的1682。每百万Token输入、输出价格为8元、28元,与GLM-5.2保持一致;编程体感较前代提升50%。
- GLM-5.3-Flash(8月26日上线并开源):GLM-5系列首个原生多模态模型(320B-A18B),在AA综合智能指数中取得57分,与Claude Opus 4.8持平,定价仅为GLM-5.2的1/10,每百万Token输入0.8元、输出2.8元。此前它曾以代号“Ox-Alpha”在OpenCode与OpenRouter匿名公测,凭出色的推理速度与智能表现成为当周最受欢迎模型,创下双平台调用量新高。
- GLM-5.3-FlashX(9月18日上线):最高输出速度200TPS,官方称该模型运行在10万张国产芯片组成的推理算力上,并在Infra侧进一步加大投入与推理优化,形成智能、价格、速度的全面竞争力。
- GLM-5.3 HighSpeed(10月灰度):在ZCode中对订阅用户随机灰度,实测速度超490TPS。
【图表:GLM-5.3与GLM-5.2编程基准对比图】
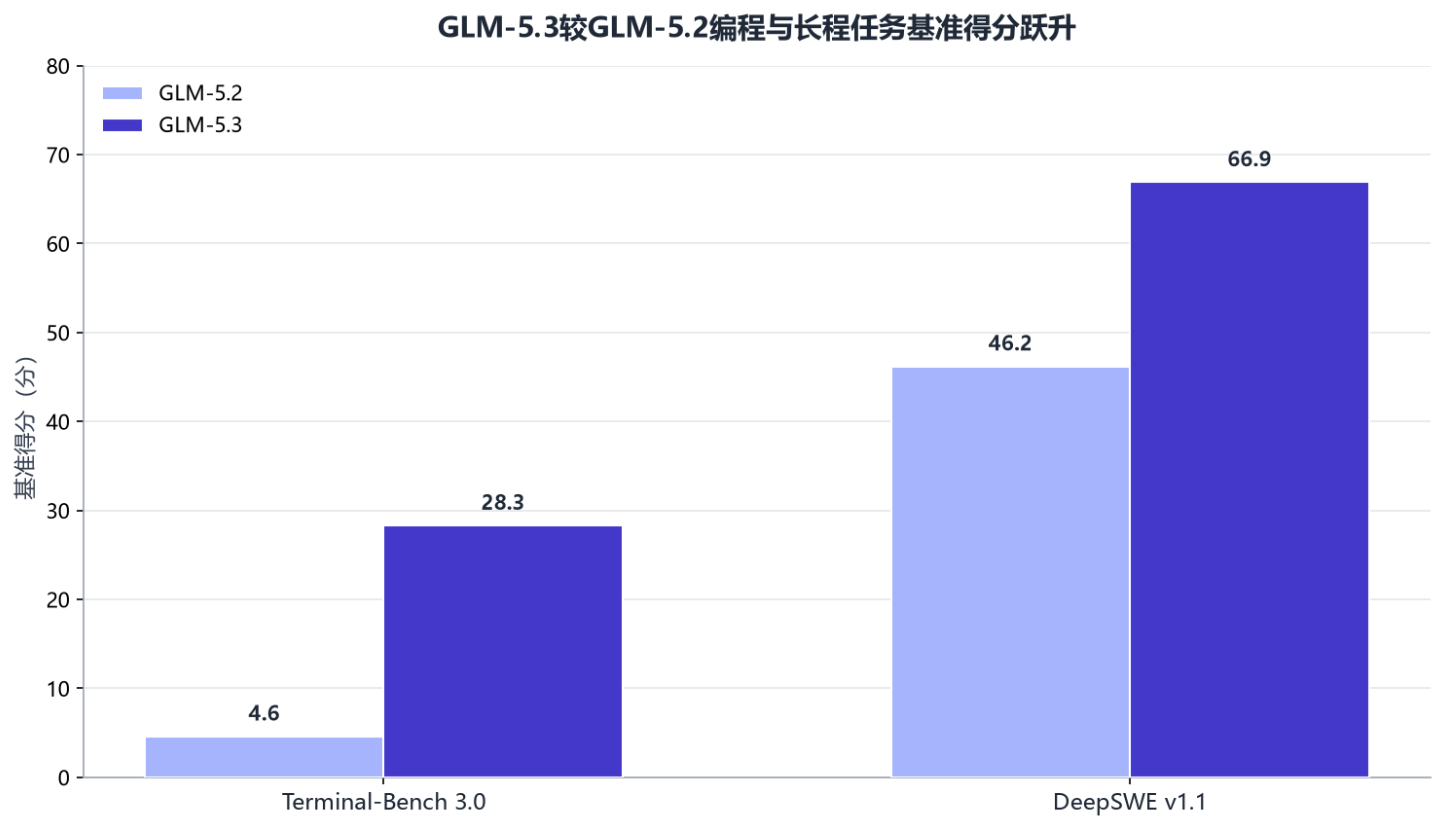
基准对比显示,GLM-5.3在保持7530亿参数、不更换基座的前提下,通过后训练Scaling将Terminal-Bench 3.0得分从4.6分提升至28.3分、DeepSWE v1.1得分从46.2分提升至66.9分,验证了“智能上限”与“服务速度”可以并行推进——这也是高速版敢于以旗舰模型为底座的前提。
生态侧,国产算力已成为智谱高速策略的底座:GLM-5.3-Flash依托国产芯片集群承载OpenCode与OpenRouter的真实线上流量;壁仞科技、摩尔线程等国产芯片厂商均在模型发布前后完成快速适配。
六、行业提速竞赛开打:从“比分数”到“比速度、比成本”
GLM-5.3 HighSpeed的亮相并非孤例,而是全球大模型“提速竞赛”的延续。海外,谷歌Gemini 3.7 Flash将重心放在速度与实用性上,输出速度飙升至每秒340个token,并配合半价策略——至2026年底前,每百万Token输入、输出价格分别为0.75美元和3.75美元,只有Gemini 3.6 Flash标准价格的一半。
竞争的标尺也在变化。有市场分析指出,AI竞争正从“最高分”转向“每美元完成多少任务”:GLM-5.3在AA综合智能指数中取得60分,每项任务成本约0.68美元,低于Kimi K3约19%,也比GPT-5.6 Sol低45%。当模型能力差距收窄,推理速度与成本效率就成为争夺开发者的关键筹码。
生态数据同样佐证了中国模型的势能:据Hugging Face《2026年春季开源现状报告》,中国开源大模型全球下载量占比达41%,首次超越美国;OpenRouter数据显示,2026年3月中国大模型周调用量达4.69万亿Token,连续两周超越美国,海外开发者占比超47%。在此背景下,“大模型提速竞赛”已然开打。
七、冷静观察:灰度速度不等于上线速度
需要指出的是,灰度测试中的飞快速度目前只能作为参考。智东西分析称,GLM-5.3 HighSpeed内测展现出的速度,最终还得看实际上线后、对外规模化提供服务时的表现。同时,该模型目前只对ZCode订阅用户随机开放,没有明确的内测申请入口,输入输出价格尚未披露,Lite套餐用户暂未获得体验资格。
结论与展望
GLM-5.3 HighSpeed在灰度阶段实测超490TPS,无论最终上线速度如何,都已经把“推理速度”重新推上大模型竞争的主舞台。对开发者而言,Coding Agent的体验瓶颈正从“答得好不好”转向“跑得快不快”;对行业而言,速度、智能与价格的“三维竞争”正在取代单一跑分,成为模型厂商的新考场。
若智谱能在规模化服务中兑现接近490TPS的速度,并延续GLM-5.3系列在编程基准与价格上的竞争力,AI编程工具的“实时协作感”将进一步逼近人类同事的节奏;而海外厂商在速度与价格上的激进策略,也意味着这场竞赛没有缓冲期。