10月21日,面对AI与数学之争,新晋菲尔兹奖得主、芝加哥大学数学教授邓煜,与SAIR Foundation主席、菲尔兹奖得主陶哲轩最近在SAIR播客上探讨AI时代数学的未来。这场对谈发生在一个特殊时点——此前两周,OpenAI一次性公开722份数学预印本、一天后因符号错误撤回3篇的争议仍在发酵。对谈中,陶哲轩批评科技公司利用AI研究数学"本质上是提炼他人的研究成果",呼吁"邀请一些数学家参与,在项目开始之前就加入,而不是事后再来收拾残局";邓煜则直言,如果连AI的思维链都看不到,"这就太荒唐了"。两人同时强调:保持开放是AI必须具备的关键特质,"关键是增强人的能力"。本稿件对这场对谈及其背后的AI数学争议作全景解读。
一、事件背景:722份预印本争议与SAIR播客对谈的缘起
这场对谈的两个声音,分量都不轻。邓煜是新晋菲尔兹奖得主——今年7月,他在国际数学家大会(ICM)上获得菲尔兹奖,被介绍为实现了中国大陆数学家菲尔兹奖"零的突破",获奖工作包括对希尔伯特第六问题的攻克;他目前是芝加哥大学数学教授,主要研究偏微分方程、概率论。陶哲轩是加州大学洛杉矶分校(UCLA)教授、菲尔兹奖得主,同时担任SAIR Foundation主席——按澎湃新闻的机构介绍,这是一家由陶哲轩发起、多位诺贝尔奖得主及全球顶尖科学家共同指导的非营利性研究机构,致力于解决科研体系的结构性瓶颈,以科学、安全的方式加速向AGI和ASI演进。
对谈的导火索,是今年10月OpenAI的一次"批量发布"。10月6日,OpenAI一次性公开722份由其内部前沿模型生成的数学预印本(手稿),声称在几何、计算机科学、代数及其他学科的372个数学问题上取得进展,覆盖数论、几何等多个领域,其中包含准黎曼猜想、四维挂谷问题等长期悬而未决的难题。OpenAI表示,绝大多数结果均采用相同流程、使用尚未发布的内部模型获得,模型此前尝试了约4000个研究问题,平均每个结果耗费约3小时ChatGPT Pro计算量。转折在次日出现:10月7日,OpenAI因一处符号错误撤回3篇预印本;10月8日,官方更新日志显示另修订14篇、更新13篇引用,公开目录由722份降至719份。
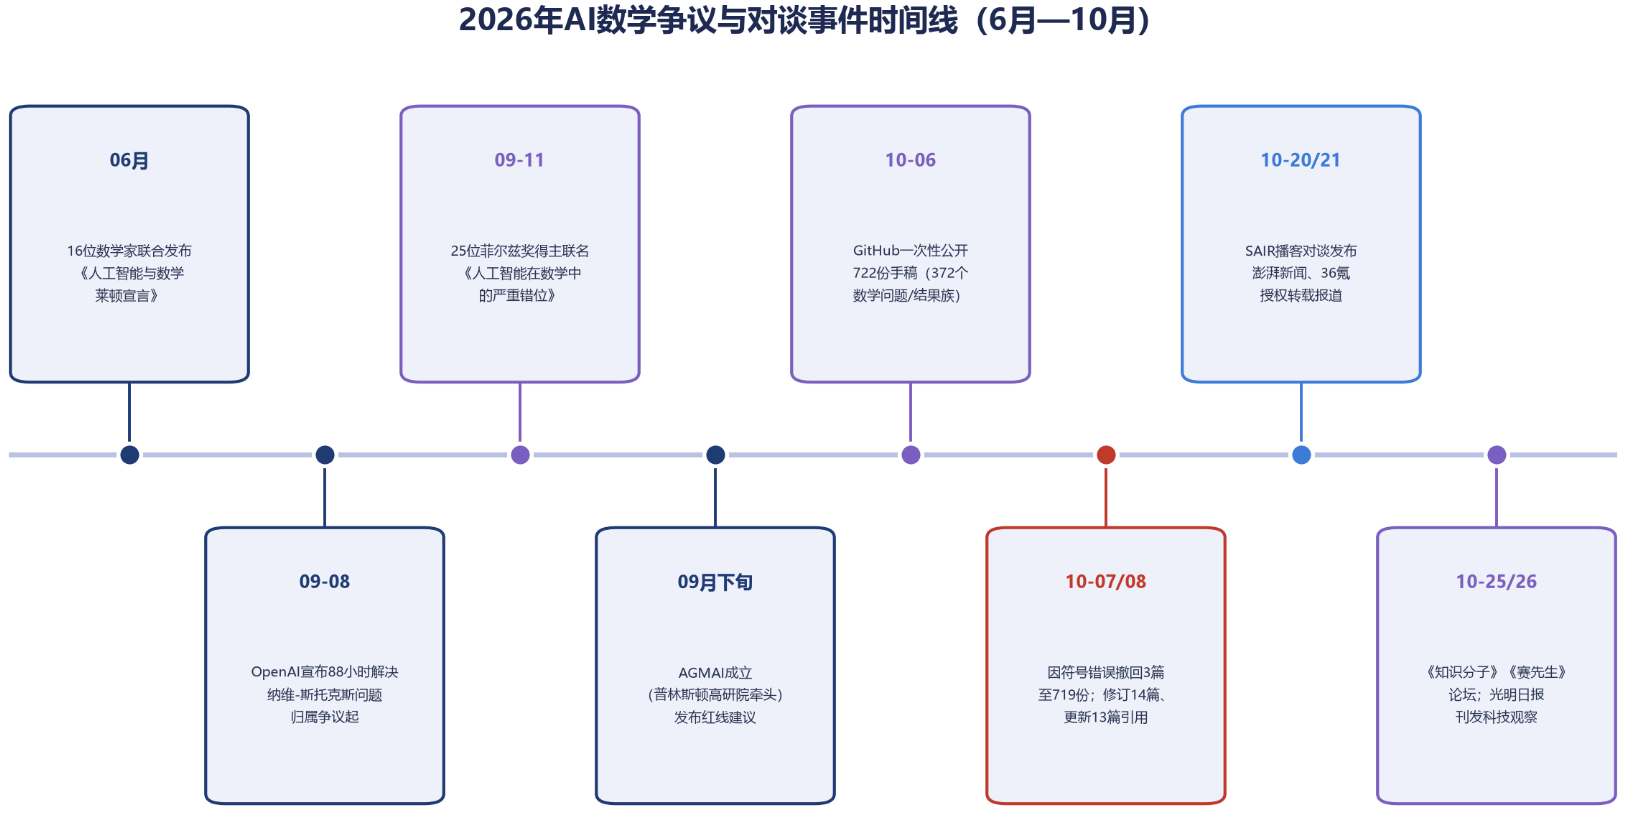
图1 2026年AI数学争议事件时间线
梳理近半年的时间线可以看到,这场对谈并非孤立事件,而是数学界与AI公司紧张关系持续升级后的集中回应。6月,16位知名数学家联合发布《人工智能与数学莱顿宣言》。9月8日,OpenAI宣布其一款未公开模型组织约一万个AI智能体、用88小时生成千禧年难题之一纳维-斯托克斯方程存在性与光滑性问题的证明手稿,并称不会申领该问题100万美元奖金——这一事件余波未平:纽约大学柯朗数学科学研究所教授布克马斯特质疑OpenAI模型是否接触过其与一名Anthropic研究员在相近方向的成果对话数据,OpenAI否认访问其数据,但说明前后存在反复,该质疑未获独立证实。9月11日,陶哲轩、邓煜等25位菲尔兹奖得主发表联名信《人工智能在数学中的严重错位》,警告AI公司将解决数学难题当作检验模型性能的基准,"AI公司的目标与数学共同体的目标存在严重错位"。联名信写道,解决一道数学难题,过去往往意味着取得了新的洞见、发现了有趣的方法,解题本身仅仅是工具,是实现概念理解和洞察这一首要目标的途径;"AI以越来越快的速度大规模生产可以简单判定为'真或假'的命题,可能摧毁孕育新思想的沃土,而不是为新思想注入活力。"联名信还警告,这些解答往往仓促公布,没有时间形成严谨完整的书面论述、提炼出新方法和新思想,以及引用他人的相关前期研究。9月下旬,OpenAI宣布与数学家合作成立独立数学咨询小组"数学与人工智能顾问小组"(AGMAI),由普林斯顿高等研究院牵头、成员包括全球多家机构的9名数学研究人员;该小组此前建议前沿AI实验室停止在专有、外界无法访问的模型上测试高难度数学问题,并要求披露模型名称、提示词、推理链、耗时及计算成本等信息。值得注意的是,AGMAI同时声明,其咨询角色不构成对OpenAI获取或发布这些结果的认可,最终仍需由数学界评估相关建议是否得到充分执行。
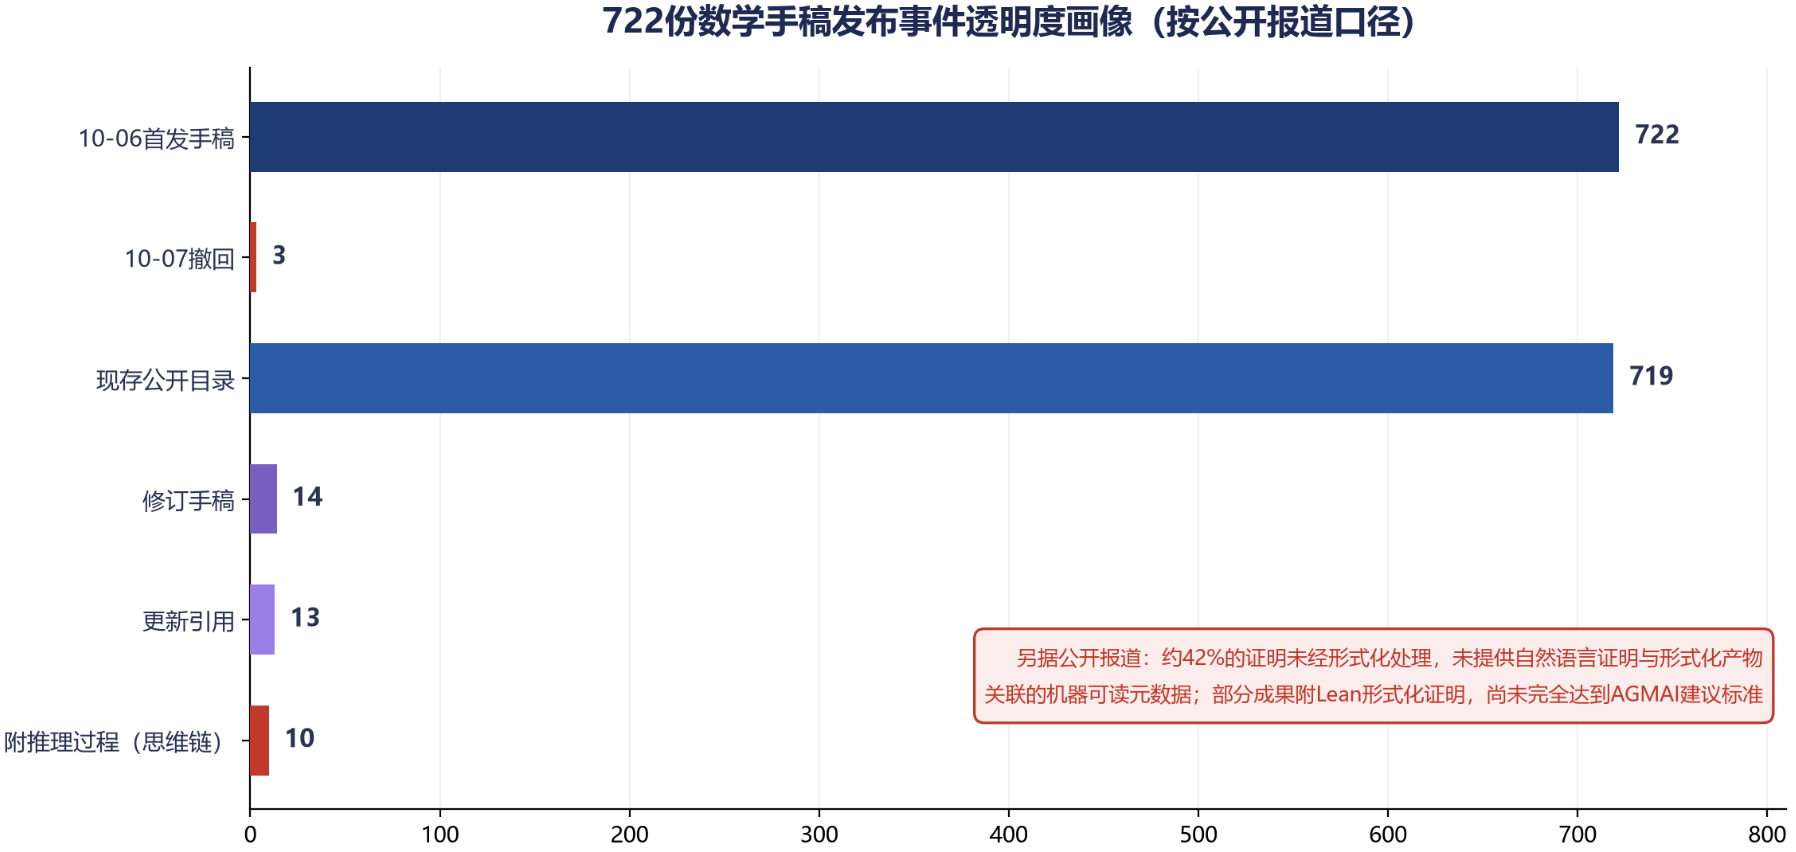
图2 722份数学手稿发布事件的透明度画像
而从公开情况看,此次发布尚未完全达到AGMAI标准:719份文稿中仅10份披露了模型得出结论的推理过程(思维链),约42%的证明未经形式化处理,也未提供自然语言证明与形式化产物关联的机器可读元数据;部分成果则附有可由计算机逐步检查逻辑推导有效性的Lean形式化证明。在此背景下,数学界的反弹持续加码:人类数学协会(AHM)发布声明,批评OpenAI完全无视科学研究的规范,而这些规范正是确保数学研究保持可信、合乎伦理且符合公众利益的保障;陶哲轩在个人博客转发了该联合声明。光明日报10月26日的科技观察则记录了学界的另一面:722份手稿中数十项被数学家认为达到了菲尔兹奖级别,有人惊呼这是"数学末日",也有人冷静指出这是"世界数学史的分水岭"。10月20日前后SAIR峰会期间,这场对谈发布;10月21日,两位主角终于正面回应。
二、溯源之争:AI提炼人类成果,开放科学与思想链条何以延续
对谈中最尖锐的批评,指向AI数学成果的思想源头。陶哲轩认为,科技公司利用AI研究数学,本质上是提炼他人的研究成果。"因为它们从别人的研究中获取数据,从别人的论文中获取数据。那我们到底该怎样追溯这些来源呢?"
这一判断的根基,是陶哲轩所称的开放科学传统。他表示,学术界遵循开放科学的原则已有数百年之久——"我们把科学文献视为共同财富。所以我们发表论文,这些论文当然期刊是要付费的,关于这一点确实有一些值得讨论的争议,科学文献应该向所有人开放,本来就应该利用他人的文献,同时规范地注明引用,这样才能追溯思想的来源,科学就是这样进步的。"在他看来,问题在于AI的工作方式与这一传统之间的错位:AI能把科学家和数学家数千年积累的全部文献转化成答案,但过程却有些不透明。这些AI能给出答案,有时还会说自己用了某篇论文中的一项具体结果;但有时,它们无法一路追溯到源头,或者没有展示这些想法来自哪里——"这就开始切断思想的传承链条,这实在可惜。"他补充说,解决一个问题时,我们学到的一部分内容,恰恰是它受到过哪些影响、哪些关键想法已经以不完整的形态存在于文献之中;也许未来的AI会更擅长追溯自己的来源,但目前的技术在这方面做得很差。陶哲轩进一步指出,科技公司有动机淡化这一点,因为它们希望让人觉得AI仿佛凭空解决了问题,"但它们和人类科学家一样,也建立在数千年来人类努力的基础上。它们有时会注明贡献归属,有时却不会。这方面需要做得更好。"
邓煜给出了一个更具体的例子:有人直接使用别人的想法,这些想法是他人早先输入ChatGPT而后被拿来生成证明。他表示,最终的目标,是有一套办法,让你真正能够追溯想法的来源。而在当下,思维链几乎是唯一的观察窗口——"就目前而言,如果能看到AI的思维链,你至少还能大致了解它是怎样得出这些结果的、参考了哪些资料。可现在连这些都看不到,这就太荒唐了。"他同时强调,"如果我们想拥有不依赖这些大公司的工具,那么就要朝这个方向努力,这是目标之一。"值得注意的是,国内媒体将这句话译作"就实在太荒谬了",措辞略有差异而语义一致;两个版本的并读,恰恰说明"思维链不可见"是两位数学家共同确认的事实,也是这场溯源之争的技术症结。
三、参与之变:事前邀请数学家加入,而非事后收拾残局
如果说溯源之争关乎过去——AI的成果从哪里来,那么对谈的第二条主线则关乎流程——数学家应当在哪个环节介入。陶哲轩先解释了"批量解题"为何会发生。他表示,科技公司之所以发布新闻稿、宣称解决了数学问题,部分原因在于数学界本身也十分看重解决这些问题。过去,解决了这类问题就意味着数学家理解透彻、能讲清楚,能根据自己的工作提出新问题、培养学生,"我们为解题颁奖,实际上是在奖励这一整套更广泛的工作。"
但如今,激励的坐标系发生了偏移。陶哲轩表示,"但解决问题只是其中最容易衡量的指标,如今这几乎成了顺带的事。"AI科技公司几乎在无意间解决了这些数学问题,对它们来说,这只是服务于更一般性的模型训练,成果成了某种副产物,甚至可以说是"有毒废料",接着它们得想办法处理或者由数学家来处理。这并非陶哲轩第一次使用如此尖锐的比喻——此前在Numberphile访谈中,他就将机器批量产出的证明比作"毫无营养的合成食品",逻辑校验可能及格,人类却并未因此获得深刻的数学理解,并批评商业公司的做法是"炸鱼式做题(dynamite fishing)",冲击了青年学者的研究生态。而在这场批量发布中,数学共同体实际扮演的角色同样令人不安:对谈主持人直言,要避免大家耗费时间"给这样的成果充当免费的调试员";在25位菲尔兹奖得主的抗议语境中,这一角色被形容为免费的"找虫民工"——何况对谈中还提到,部分手稿的文字证明与Lean代码之间存在脱节。
由此,他提出了本次对谈传播最广的主张——改变激励机制和价值体系,让数学家从事后的"收拾残局"者,变为事前的参与者。"我们确实需要更明确地表明,我们不是为了解题而解题,我们想要更广泛的理解和洞见。理想情况下,产出这些证明的公司也应该和我们合作,把它们解释清楚。也许应该邀请一些数学家参与,在项目开始之前就加入,而不是事后再来收拾残局。"陶哲轩同时给出了一个更硬的边界:到了某个时候,必须表明,如果只是解决问题,却没有带来其他有价值的东西,就不会进入学术文献。
他并不讳言自己的态度。陶哲轩表示,科技公司这次发布中有十来个问题他都很关心,"有一天我会去读,但眼下它不在我的优先级里。目前的讲解方式,还没有真正激起我的兴趣。不过我们最终会去看的,只是进度会慢得多。如果他们能与我们合作,就会快很多。"这段表态与AHM声明的抵制立场形成了微妙的层次差:抵制是共同体层面的姿态,而"暂时不读"是一位顶尖数学家用注意力投票——合作与否,直接决定这些成果进入学术视野的速度。
四、能力之基:两条边界、慢科研平衡与"增强人的能力"
对谈没有停留在批评层面,两位数学家系统阐述了他们眼中AI时代数学研究的价值坐标。邓煜从"为什么做数学"讲起:"说到底,问题在于我们为什么做数学。不同的人可能有不同的答案。对我来说,答案是理解这个世界。这里说的世界,既包括现实世界,也包括抽象的数学世界。"由此他提出了"两条边界"的论述:第一条边界界定的是那些已有证明的问题,它们是所有问题中的一个子集;第二条边界界定的是我们能理解证明的问题,这是已有证明的问题中的一个子集。过去,第二条边界不成问题,因为只要有证明,就有人能够理解它;而现在有了AI,如果只有AI知道证明,就产生了第二条边界。"所以我们的价值观其实一直是一致的,只是情况发生了变化。"
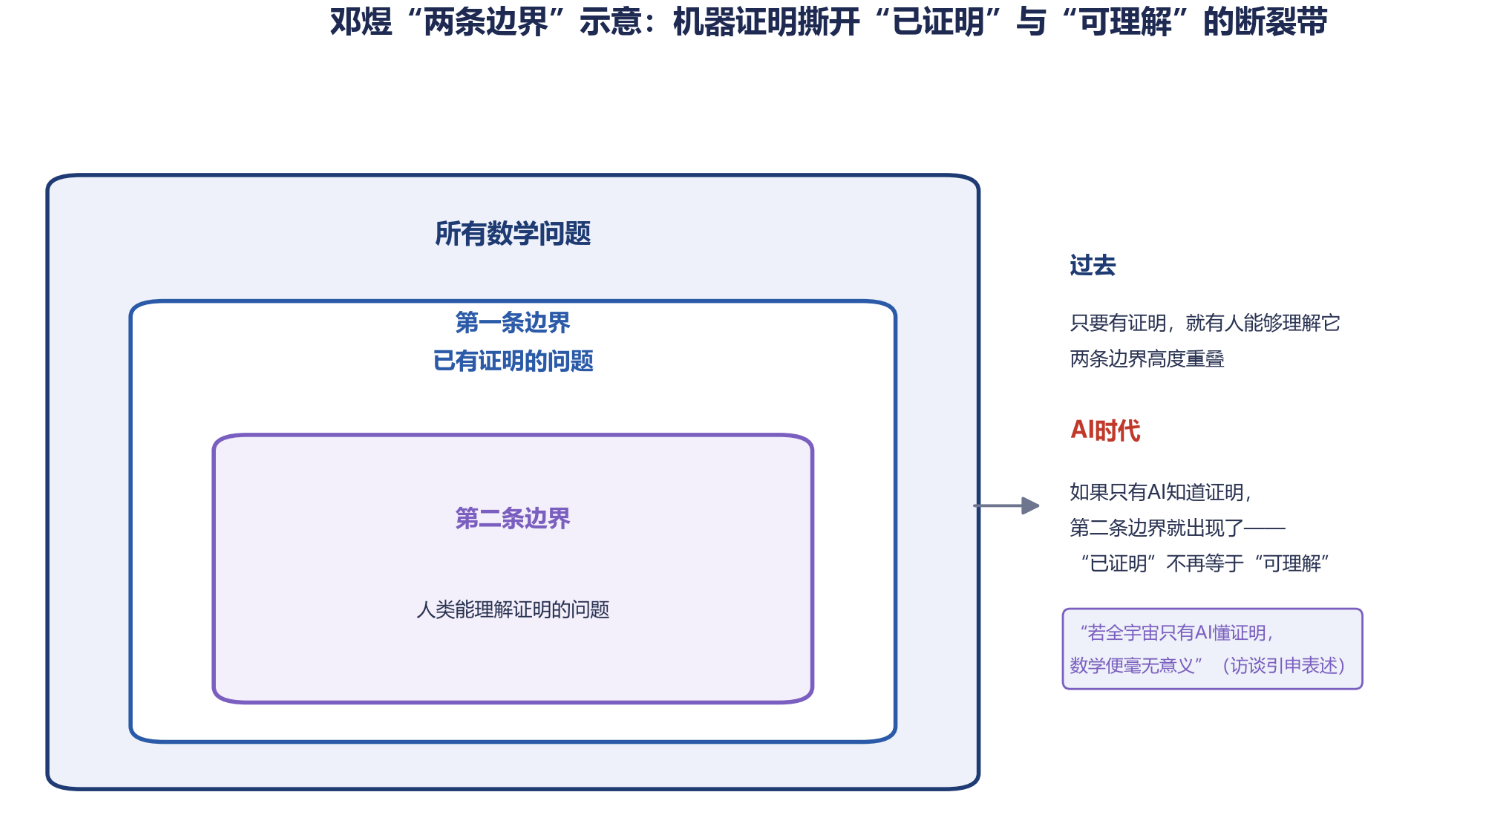
图3 邓煜"两条边界"示意:机器证明撕开了"已证明"与"可理解"之间的断裂带
值得注意的是,邓煜对AI证明本身的评价相当正面。"单看证明本身,现在局面很好。AI正在向人类学习,学习人类的思路,也在创造自己的新思路。而这些新思路,我们也能够真正理解,并在此基础上发展出自己的新想法。这就是人类与AI的共同演进。"他同时认为,AI能大大拓展数学的边界、研究的边界;给定任何一个问题,只要AI给出了答案,往往还会有几个难得多的新问题由此衍生,就可以开始探索。
陶哲轩则把讨论引向节奏与能力的权衡。他表示,AI正在赋予我们更多能力,许多过去很难完成的任务,现在可以自动完成了,但它也在取代那些较慢、却很有价值的做事方式,应找到恰当的平衡——保留那些慢节奏研究方式的种种好处,做科学和数学研究要增进理解、建设社区、保有人类对学科的理解,同时用上这些强大的方法大幅提高效率。这也是把这场对谈概括为"呼吁数学慢科研"的由来。
"关键是增强人的能力。"陶哲轩表示,要设法为科学家提供工具,也为其他科研人员等提供工具,让他们的能力真正增强——"当你使用这些工具时,你自己也会变得更聪明,理解得更深,而不是牺牲自己的能力,依赖AI来获得答案。"在他看来,年轻一代眼下可能有很多焦虑甚至绝望,因为数学领域的许多老规矩都在发生变化,"但一旦大家明白可以做些什么,尤其是当工具真正到了他们手里,他们就会迎接挑战,想出极富创意的新做法……我对年轻一代充满希望,只要有合适的工具,他们就能做出惊人的成果。"
落到人机分工的操作层面,邓煜的答案是"理解先行"。AI可以把事情做得很好,前提是人类已经对某个问题有了充分理解,可能已经有了证明思路——这首先要求你充分理解这个问题,并且有一个计划,比如证明的整体思路;此时把繁琐浩繁的推导交给AI,让它节省时间精力,研究者得以专注于更根本的问题。一个直观的样本是:邓煜在对谈中举例,他的长期合作者、偏微分方程专家布约恩·布林曼(Björn Bringmann)展示了这样一个案例——一个随机偏微分方程问题,人类团队此前已经吃透其图景、设计出整套方案,将全局规划输入GPT Astra测试后,约一两天便告解决。而提出正确的问题、全局规划、提出全新想法的能力,既是"让你能够有引导AI的能力,也是让你能够独立于AI开展工作的能力,这就是我们今天反复强调的'理解'。"这一判断在学界并不孤单——光明日报报道的10月25日《知识分子》《赛先生》论坛上,2026未来科学大奖得主、北京大学教授袁新意同样把数学发展拆为提问、解题、总结三个环节,认为"AI解题能力超强,总结能力可期待,但是提问的能力可能是瓶颈"。
五、开放之路:构建开放数学模型与年轻一代的创意空间
对谈的收束点,是一条建设性路线:构建开放数学模型。邓煜从"工具与体系"的关系讲起:"要正确使用AI。AI是一种工具,无论好还是坏,都不是它与生俱来的属性。真正重要的是整个体系,也就是围绕这种工具形成的体系。"他强调,保持开放是AI必须具备的关键特质,这样它才能健康发展,有益于社区,并持续带来益处,从长远来看造福社区。他认同陶哲轩的愿景并补充:用于科学的AI也应当开放,不应建立在任何闭源AI工具之上——这也是两人共同署名构建开放数学模型的原因。
按照访谈时的进展,团队的新模型仍在筹备,率先推出的是Open Math OS——一个整合现有开放模型、研究工具与协作功能的工作平台。起步阶段,平台使用的是现有开源模型,使用者无需自行部署模型,也不用自行购买GPU;Open Math OS希望把模型与各种工具整合起来,并支持协作。在OS平台之后,是完全由学术界自主训练的下一代开源数学模型——陶哲轩表示,正在组织许多团队,汇集想法、数据、训练资源和算力,也有许多合作伙伴参与,"希望再过几个月,就能在现有开源模型的基础上,做出我们自己的模型。"
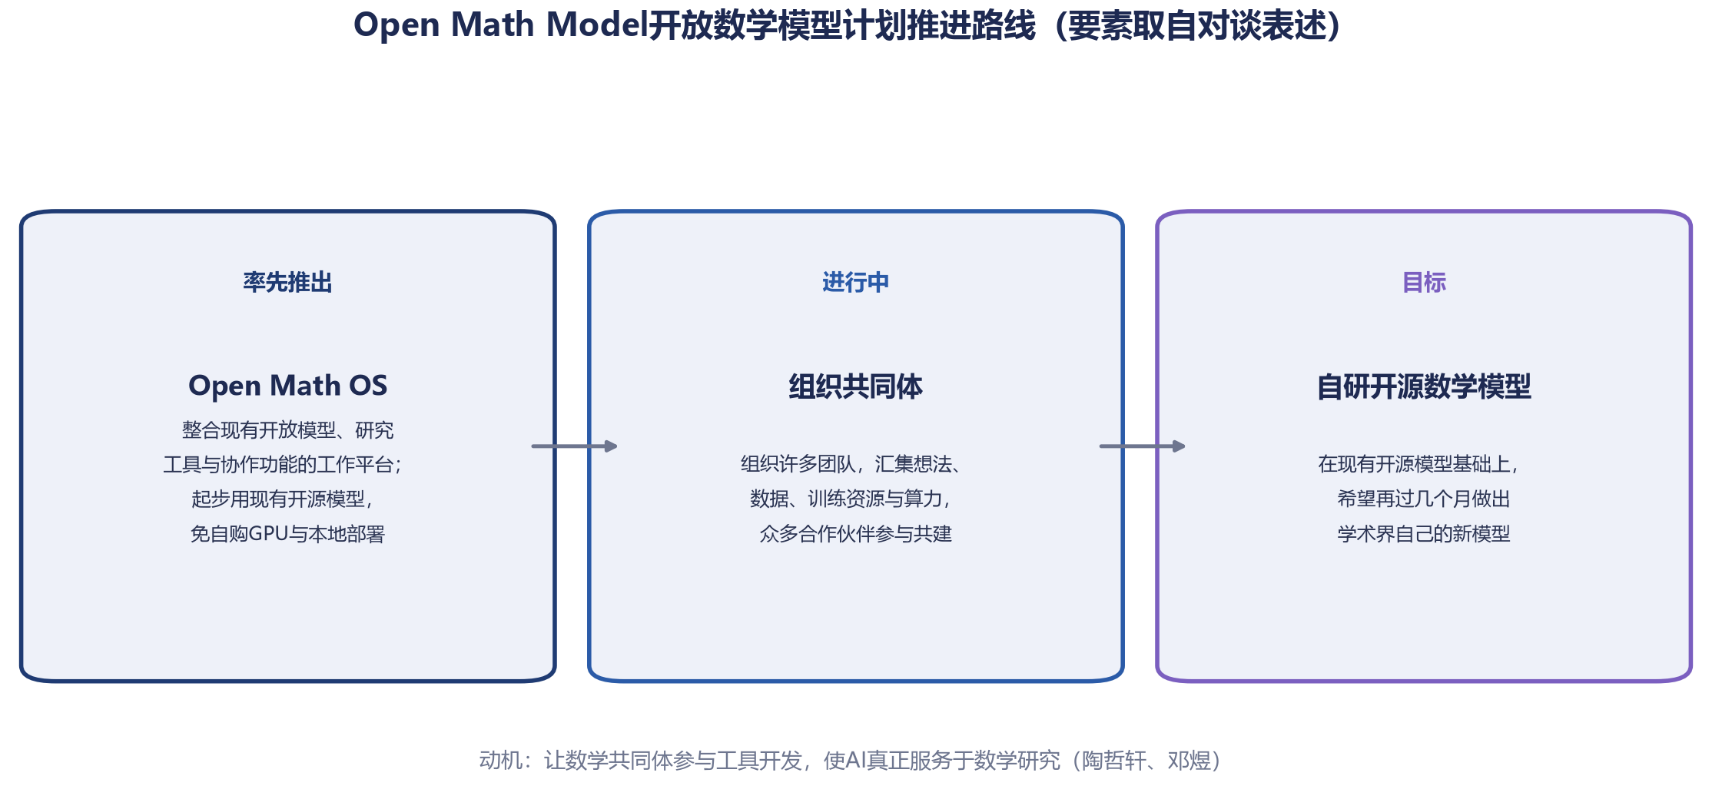
图4 Open Math Model开放数学模型计划推进路线
推动这一计划的动机,双方各有侧重。陶哲轩表示,创办SAIR时的愿景之一,就是为数学共同体提供由共同体自己开发、符合其价值观和目标的工具——大型科技公司的文献检索等工具确实有用,但"有时它们给出证明,却没有带来理解,而且引用也不完整,由此切断了文献之间的联系",因此希望独立于大型科技公司、在共同体充分参与的基础上开发工具。这也是两人参与Open Math Model开放数学模型计划的动机之一:让数学共同体参与工具开发,使AI真正服务于数学研究。邓煜则提供了趋势性的观察:他在国际数学家大会期间与SAIR团队取得联系,9月纳维-斯托克斯事件后,推出这种开放数学模型变得更加迫切;南加州大学(USC)的朋友团队做的恰好是同一件事,世界各地许多不同团队都开始做这件事——"先是数学界,继而是更广泛的学术界,都会努力让数学和科学保持开放。"
将五章连读,这场对谈的完整主张清晰可辨:溯源上,要求AI成果的思想来路可追溯、思维链可见;流程上,要求数学家事前参与而非事后收拾残局;价值上,坚持"解出来了"不等于"弄明白了",以理解为核心;节奏上,为慢科研保留空间;路线上,用学术界主导的开放工具对冲对商业闭源体系的依赖。而贯穿其中的是同一个出发点——正如陶哲轩所言,关键是增强人的能力,而不是替代人。当AI批量产出的证明越来越多,数学共同体真正在意的,始终是那条从"已证明"通向"可理解"的路径能否畅通。