近日,月之暗面开源2.8万亿参数旗舰模型Kimi K3.1 Pro。摩尔线程基于旗舰级AI训推一体智算卡MTT S5000与MUSA软件栈,完成该模型的训练适配,构建了原生FSDP2多模态训练路径,打通了从模型加载、分片调度到梯度同步的完整训练链路。
摩尔线程是国内极少数具备万卡规模集群训练能力的GPU企业。大模型训练对底层算子完备度、显存管理与分布式通信的要求极为严苛,是检验国产GPU全栈实力的试金石。依托全功能GPU(Universal GPU)与MUSA软件生态的协同积累,摩尔线程已构建起成熟的工程化体系,具备对前沿复杂大模型从“快速推理部署”到“全链路稳定训练”的支撑能力。
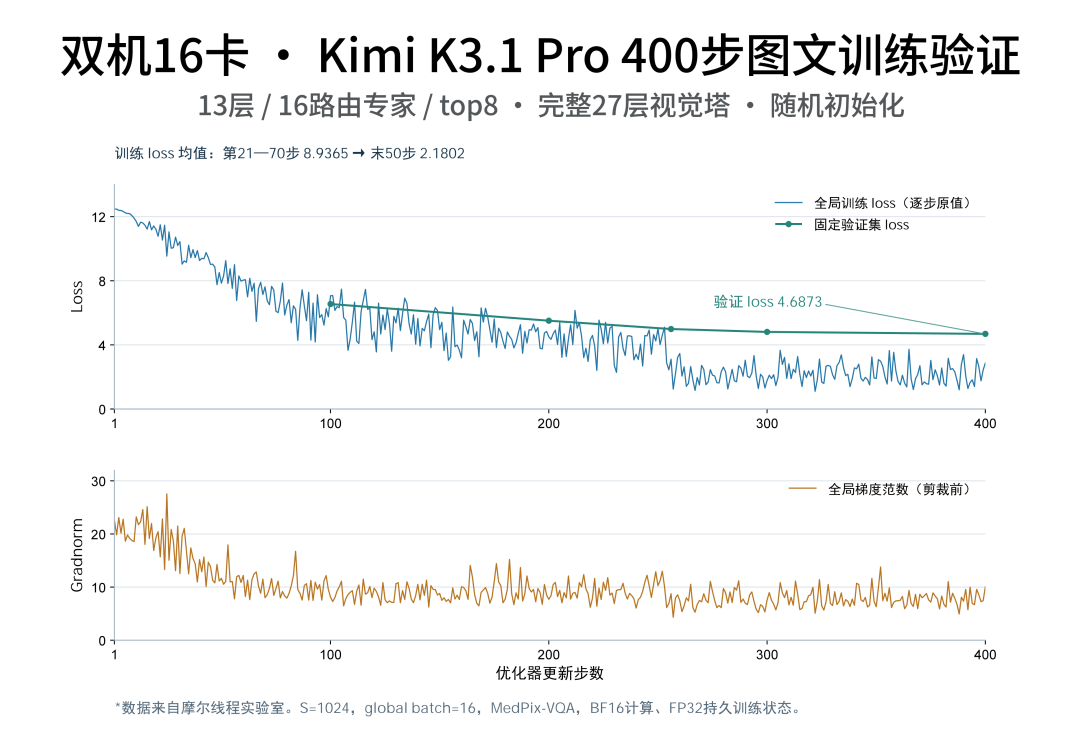
图示:双机16卡400步训练的逐步Loss与梯度裁剪前的梯度范数。验证集Loss在完成第100、200、256、300、400次优化器更新后记录。
在实际验证环节,技术团队采用保留完整视觉塔与核心机制的裁剪训练方案(13层、16专家配置),基于双机16卡完成跨节点联合训练测试*。系统连续稳定运行400步,训练损失(Loss)从8.93平稳收敛至2.18,验证了方案在多卡协同场景下的可用性与稳定性,为后续平滑扩展至完整万亿参数与大规模集群训练沉淀了可复用的工程路径。
*完整版内容与技术细节,请参见“摩尔线程开发者”公众号:《摩尔线程完成Kimi K3.1 Pro训练适配,打通万亿级多模态大模型训练链路》
▼ 亮点一:打通关键架构,衔接图文联合训练链路
Kimi K3.1 Pro作为业界首个兼具2.8万亿超大参数与100万Token超长上下文的原生多模态模型,其底层架构集合了KDA与Gated DSA混合注意力、动态稀疏检索、MoE专家路由以及高精度视觉塔。这类复杂结构的多卡协同训练难度,远超传统稠密Transformer模型。
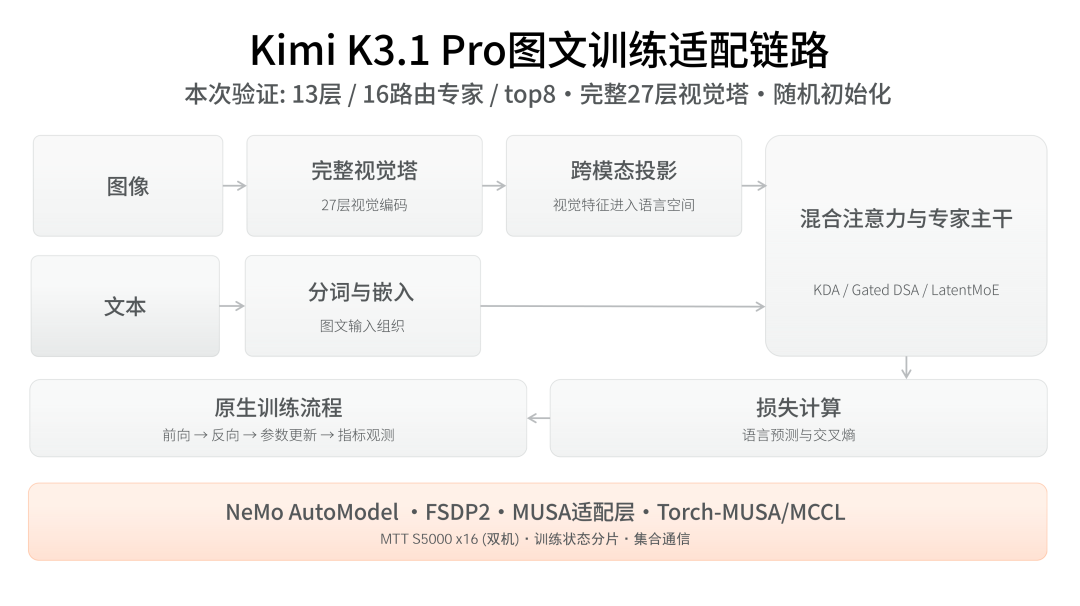
图示:Kimi K3.1 Pro 图文训练适配链路。
摩尔线程补齐新增算子的前向与梯度实现,将专家分发与归并接入统一计算图;保留完整27层视觉塔可训练参数,实现图文输入与语言监督在同一次前向、反向与参数更新中闭合。
▼ 亮点二:跨节点联合训练验证,400步连续更新平稳收敛
为快速验证跨节点分布式训练基线,本次实验基于13层语言主干、16专家(top-8路由)及完整视觉塔的裁剪配置,采用双机共16张MTT S5000,使用MedPix-VQA图文数据从随机初始化开始训练。
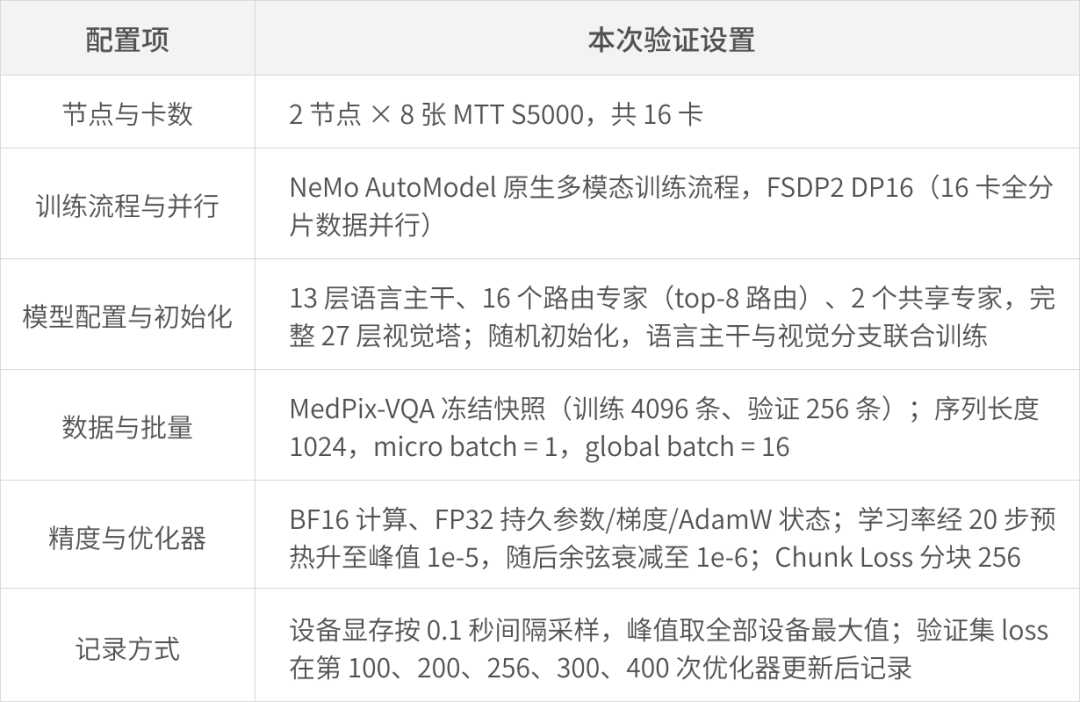
图示:实验环境与模型训练配置(表中数据来自摩尔线程实验室,测试环境与配置以本表为准)
16个训练进程连续完成400次优化器更新,全程无数值溢出、无异常中断:训练Loss从8.9365收敛至2.1802,验证集Loss从6.5297降至4.6873,显存峰值44.80GiB。梯度检查确认视觉分支实际参与训练,验证了图文联合训练链路的完整闭环。
▼ 亮点三:并行、通信、算子与损失计算,协同优化
围绕更大专家规模与更长序列的模型训练,摩尔线程从并行策略、通信调度、核心算子和损失计算四个方面完善训练能力,四项优化均已完成适配:FSDP2+EP混合并行、参数预取与梯度通信调度、高性能KDA算子,以及控制大词表显存占用的Chunk Loss分块计算(本轮验证已启用,分块长度256),为更大规模的训练配置提供支撑。
在大规模训练实战方面,摩尔线程已落地多项“国芯训国模”成果: 不仅完成了021科学基础模型(2360亿参数)从零起步的完整训练,还支撑了全球首个5D世界模型“北大EvoPhys-World”的全栈原生训练,并联合智源完成具身大脑模型RoboBrain 2.5的全流程训练, 目前正携手合作伙伴推进万亿级参数大模型的训练。
未来,摩尔线程将持续打磨从算子适配、多卡协同到自动化工具链的完整训练能力,推动前沿大模型在国产全功能GPU上从“能训”走向“开箱即训”。