近日,壁仞科技在持续推进开源生态建设方面取得新进展。一方面携手密瓜智能(Dynamia)向开源分布式推理项目llm-d提交壁砺™ 166M适配方案;另一方面,完成包括RLinf、slime、verl在内的强化学习框架的社区主线集成。从训练到推理,壁仞科技正在逐步打通国产算力接入主流开源生态的完整链路,为高性能、可扩展的模型服务与训练基础设施提供坚实支撑。
适配 llm-d 国产通用GPU融入云原生推理底座
随着大模型应用走向规模化部署,推理平台愈发需要协同处理请求调度、缓存复用与跨节点计算。
为此,壁仞科技与密瓜智能(Dynamia)合作,向开源项目llm-d提交壁砺™ 166M适配方案,提供常规推理与Prefill/Decode(PD)分离两类部署配置,探索国产通用GPU与云原生推理基础设施的融合。
llm-d是由Red Hat等企业共同推动、基于Kubernetes的开源分布式推理项目,以vLLM为核心集成引擎,结合推理感知路由与PD分离技术,构建可扩展的模型服务基础设施。它可以结合实例负载与KV Cache信息分配请求,促进前缀缓存复用、减少重复计算;同时将处理输入的Prefill阶段与逐Token生成的Decode 阶段分离部署,使平台能够针对两类负载分别配置和扩缩资源,为优化高并发、长上下文场景下的性能奠定基础。
本次向社区提交以Qwen2.5-72B模型作为PD分离适配对象,采用“1 Prefill+1 Decode”部署方式:两个实例分别部署在不同节点,每个实例通过四张壁砺™ 166M GPGPU进行张量并行计算(TP=4)。
方案复用了llm-d的routing sidecar协调请求处理,并通过vLLM NixlConnector完成KV Cache传输。Prefill实例负责输入计算并生成KV Cache,Decode实例接收缓存后继续生成输出,构成跨节点协同推理链路。
在通信配置上,方案通过UCX使用InfiniBand RDMA,并采用CPU缓冲区承接KV数据传输。该路径不仅为壁仞科技硬件接入llm-d的PD分离部署提供了具体实现配置,也为后续通信与推理性能优化提供了可验证的基础。
适配三大强化学习训练框架
除了推理侧,壁仞科技近日也将对于强化学习系列框架的支持,贡献到社区并已集成至社区主线。目前已完成包括RLinf、slime、verl在内的强化学习框架的社区主线集成,未来壁仞科技也将适配更多社区框架,并推动BIRENSUPA™生态在开源社区的持续建设。
这三大强化学习训练框架中,RLinf是由清华大学、无问芯穹联合发起,面向具身智能与智能体场景,提供“仿训推一体化”的大规模强化学习训练能力,已被多家机器人企业与芯片厂商采用。
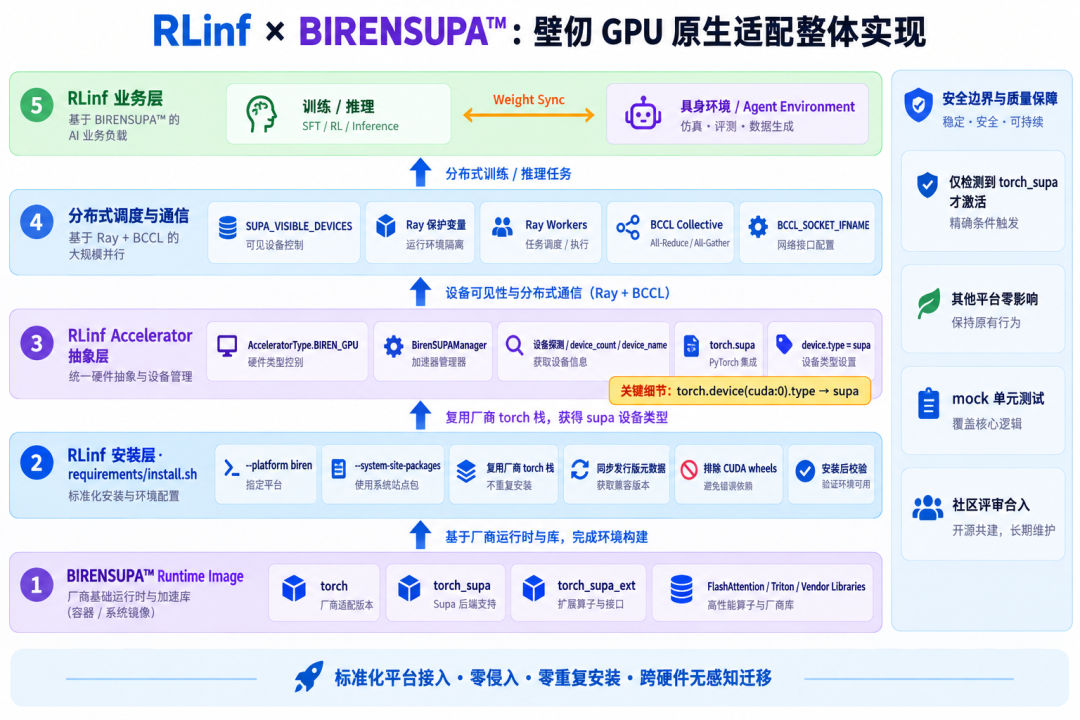
得益于RLinf对硬件平台的抽象解耦设计,BIRENSUPA™的接入遵循标准化插件模式,对其他硬件平台代码零侵入。
在标准加速器抽象层面,方案实现全量对齐,新增壁仞科技GPU管理器,完整实现设备探测、设备数量上报、设备型号序列化等接口,并注册至RLinf加速器注册表与集合通信支持列表,与主流AI芯片等既有后端处于同一抽象层。
在设备可见性与调度协同层面,通过SUPA_VISIBLE_DEVICES环境变量控制多卡可见性,同时设置Ray保护变量,避免Ray调度器覆盖SUPA的设备选择,从而保证训练进程与硬件分配严格一致。
在通信栈对齐层面,分布式训练默认采用BCCL(壁仞生态集合通信库)作为通信后端,对应CUDA生态中的NCCL,完成All-Reduce、All-Gather等多卡集合通信。
本次适配完成后,开发者无需修改任何RLinf相关代码,即可在壁砺™系列通用GPU上完整运行RLinf的大模型强化学习训练任务,实现跨硬件无感知迁移。
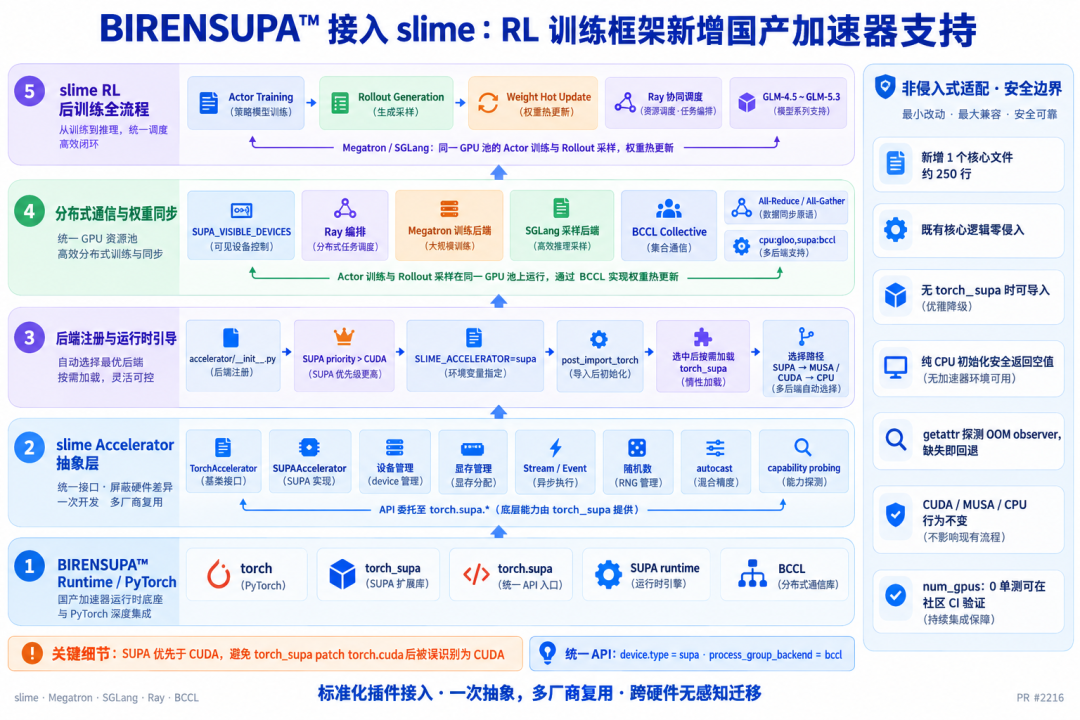
slime是智谱(Z.ai)开源的大规模强化学习训练框架,承载了GLM-4.5至GLM-5.3全系列模型的RL后训练流程。它以Megatron为训练后端、SGLang为采样后端,通过Ray编排在同一批GPGPU上完成actor训练与rollout生成的协同调度,是目前极少数完整开源、且经前沿大模型生产验证的RL训练基础设施。
BIRENSUPA™采用标准化插件开发方案,对原有其他硬件后端代码实现零侵入改造;开发者无需修改任何slime相关代码,即可在壁砺™系列通用GPU产品上完整运行slime的强化学习后训练全流程,实现大模型RL训练任务的跨硬件无感知迁移。
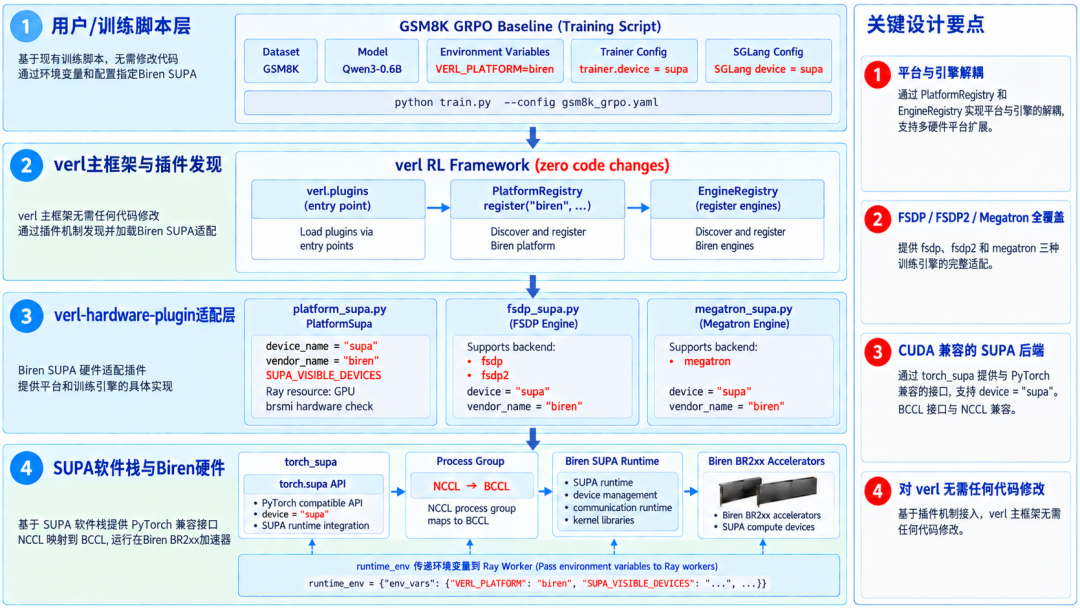
verl是字节跳动发起,面向大模型强化学习(RL)训练的主流开源框架。通过字节跳动联合智源研究院FlagOS社区设计的verl-hardware-plugin提供"一次适配、多芯运行"的外部硬件插件机制。厂商补齐平台层、引擎层与配套文档等,verl框架即可在不同芯片上正常运行,这是硬件适配的"最后一公里"。
本次适配为插件仓库新增BIRENSUPA™ 后端,让verl 强化学习训练框架在壁仞科技设备运行。
从云原生推理(llm-d)到强化学习训练框架(RLinf、slime、verl),壁仞科技通过标准化、零侵入的插件化适配方式,逐步构建起贯通训练、推理全链路的国产算力生态,让更多开发者能够以跨硬件无感知的方式使用国产通用GPU。这只是开始,面向未来,壁仞科技将持续反哺技术生态社区,聚力推进 “国芯底座+开源社区” 协同共建,夯实自主算力根基,助力国产算力产业自立自强。